本文为 Claude Code 团队成员 Lydia Hallie 撰写的文章《Choosing a Claude model and effort level in Claude Code》的中文翻译,原文发布于 2026 年 7 月 7 日。
先说结论
- 选模型,决定的是固定权重,也就是能力范围。 你可以给模型补充上下文、引导它完成任务,但它的通用知识和能力上限由训练后的权重决定。
- 思考强度不只是“多想一会儿”。 它决定 Claude 会为请求投入多少整体工作:读多少文件、调用多少工具、验证到什么程度,以及在回来询问你之前会推进几步。
- 常规任务用小模型,复杂或模糊的任务用大模型。 先使用各模型的默认思考强度;再根据你的工作类型形成稳定偏好,而不是每个任务都临时调节。
- 判断该调哪一个。 如果 Claude 已获得全部相关上下文、也确实尝试过,却依然答错,说明应换更强的模型;如果它漏读文件、没跑测试,或重构到一半就停下,说明应提高思考强度。
模型与思考强度分别控制什么
Claude Code 里有两个看似都会“让答案更好”的设置:模型和思考强度。这里的“思考强度”并不只影响思考时间,还会影响它会读多少文件、调用多少工具和做多少验证。直觉上,大模型会更聪明,高思考强度则意味着它会在答复前思考更久。
前半句是对的:更大的模型通常具有更高的能力上限。但思考强度的含义远不止思考时间。它会影响 Claude 为完成一次请求愿意做多少工作,其中包括:
- 读取多少文件;
- 做多少验证;
- 在多步骤任务中推进到什么阶段后,才回来与你确认。
思考强度较高时,Claude 往往会先多读一些文件、运行测试并复查结果,再向你汇报;思考强度较低时,它更可能要求你补充上下文,而不是自行花费 token 把问题弄清楚。
模型选择:换的是哪一组权重
当你按下回车,Claude Code 会把你的消息、系统提示、工具定义、CLAUDE.md、对话历史和已经载入的文件组装成一次 API 请求。
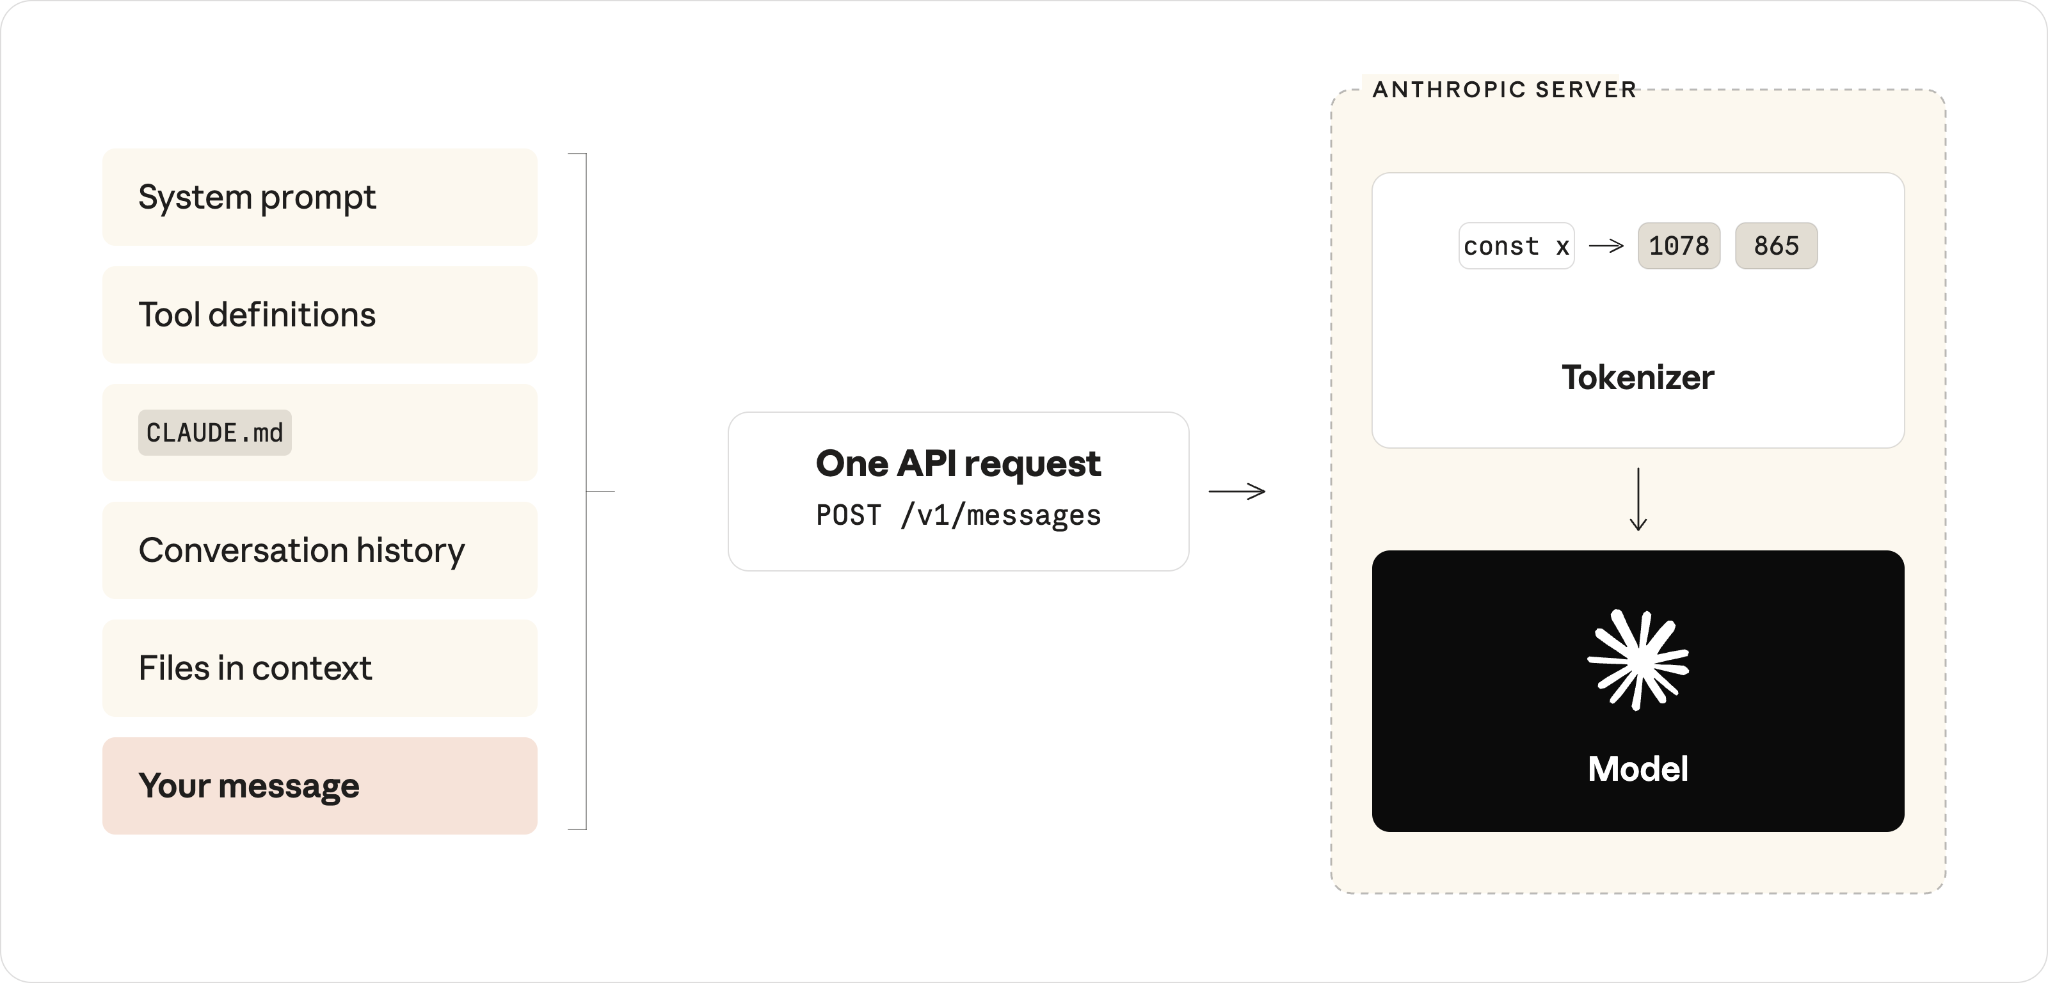
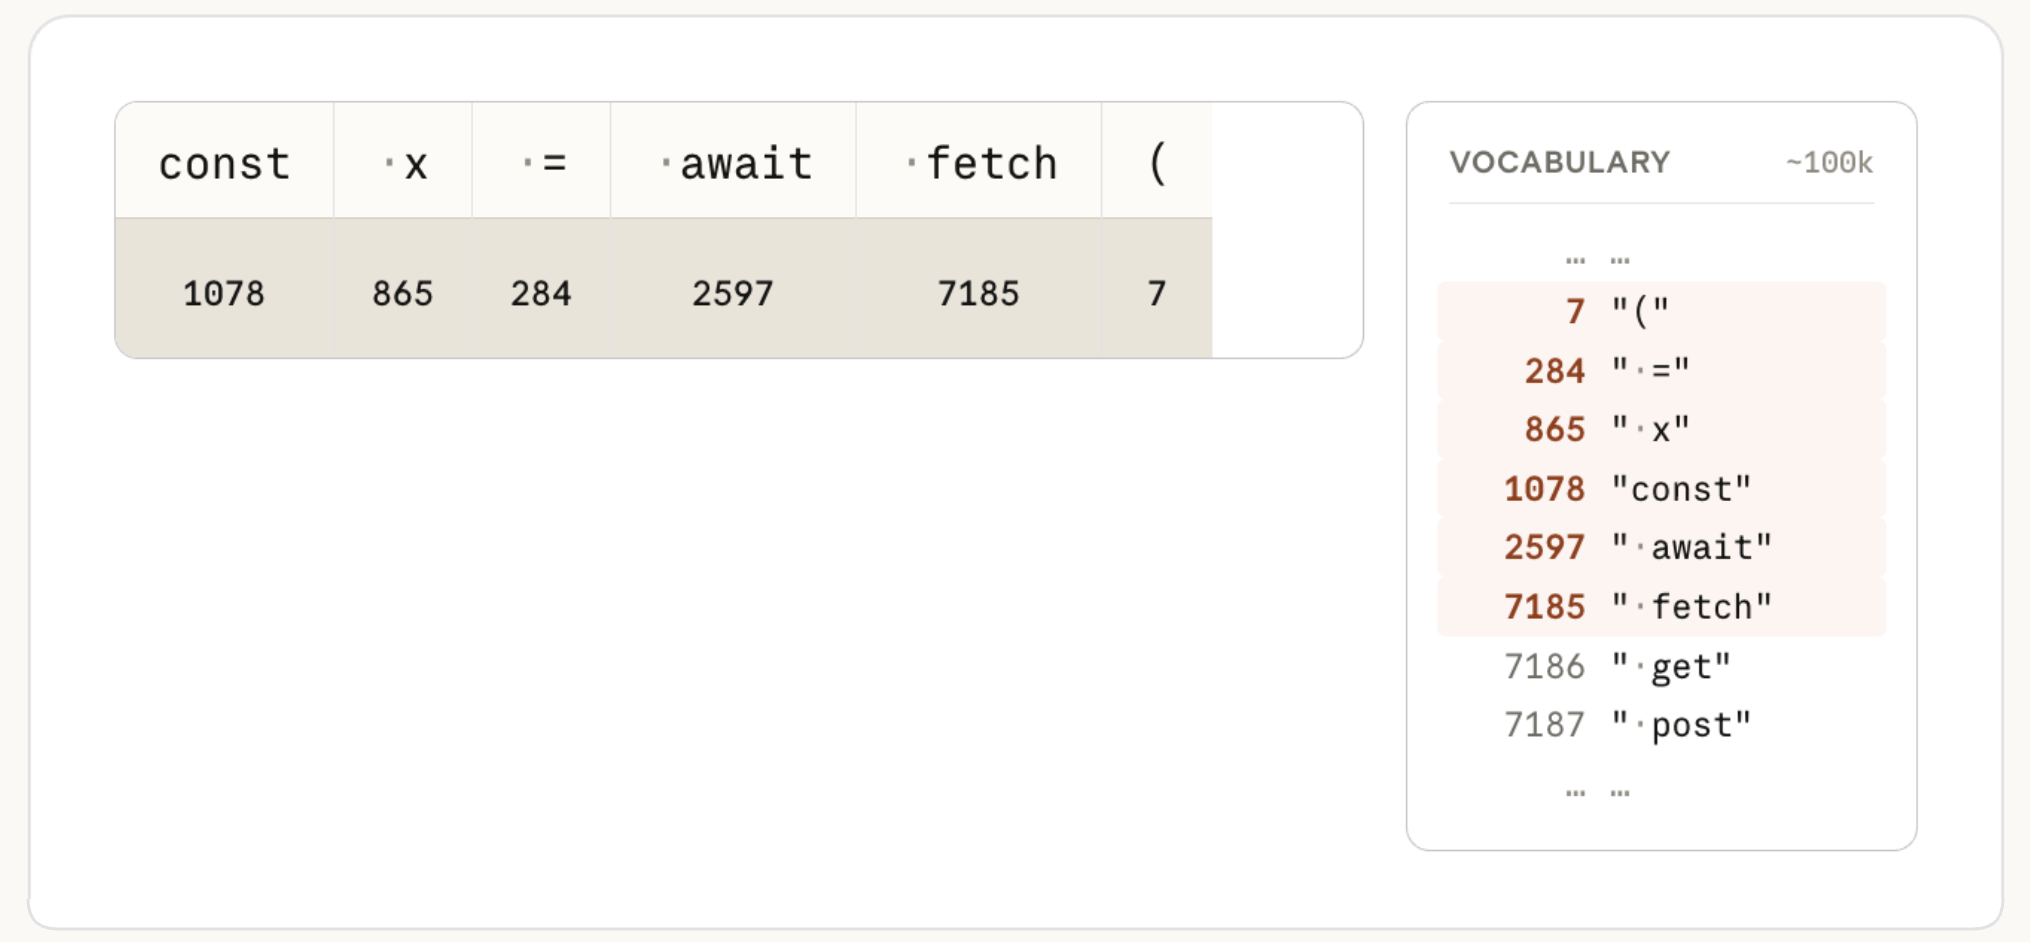
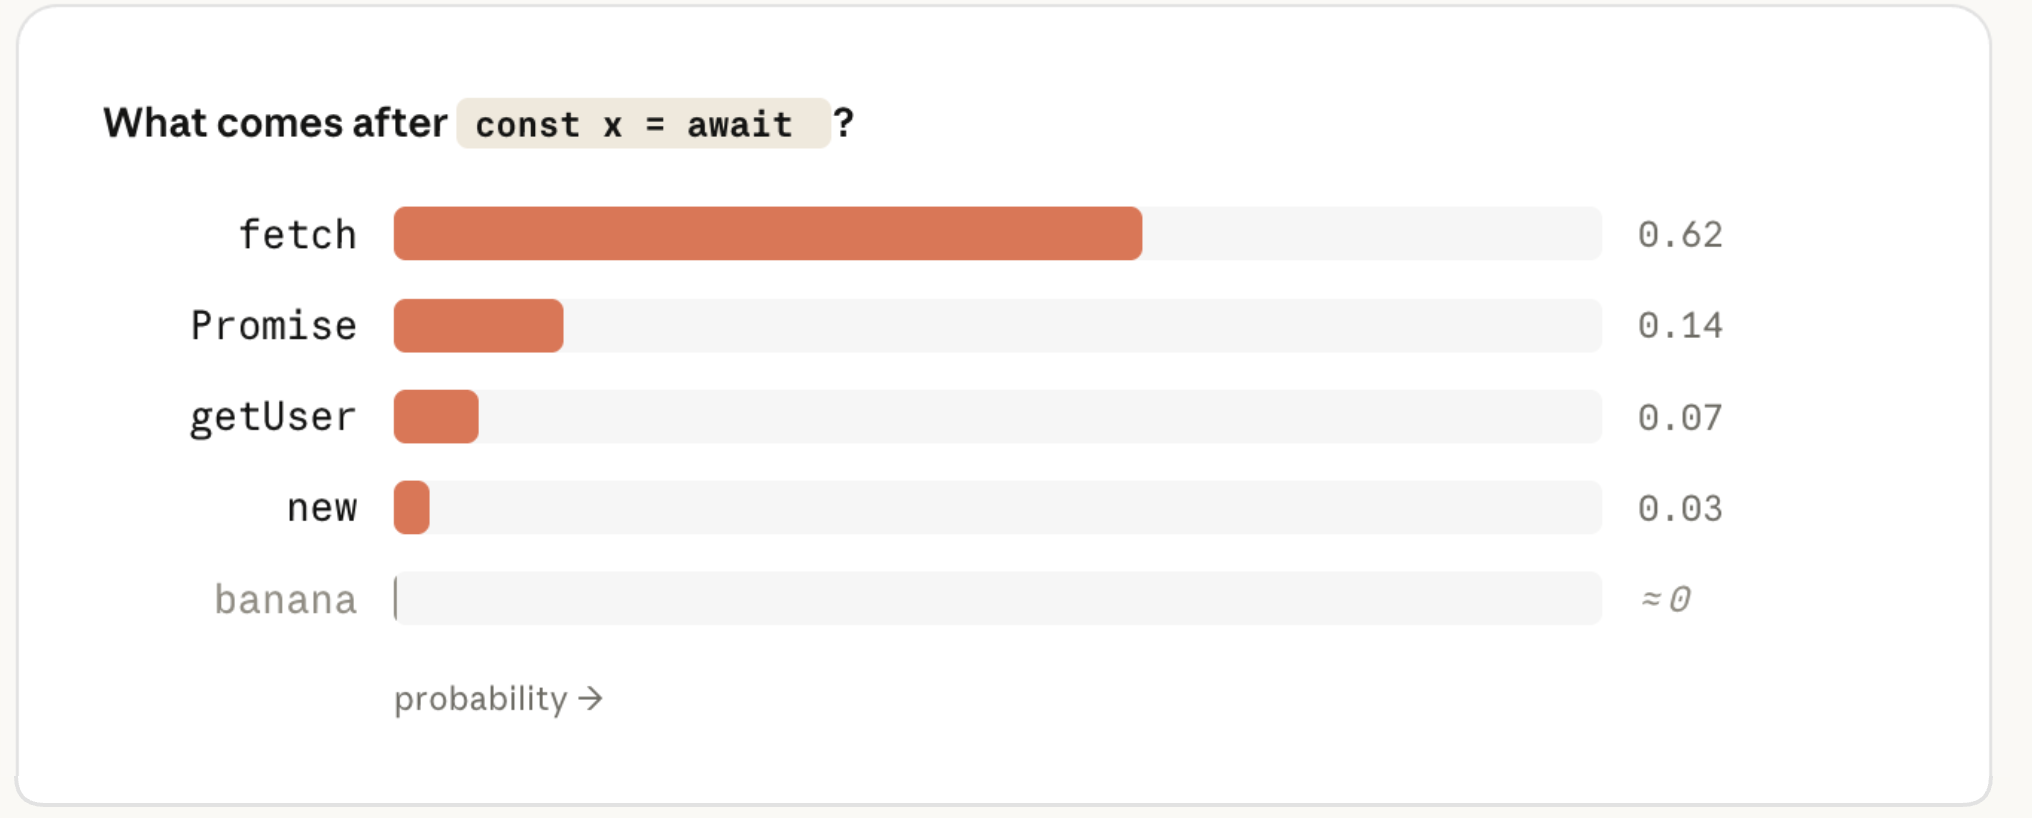
请求到达服务端后,文本首先会被分词:文本片段被映射为训练词表中的整数 ID。模型随后根据这些 token,预测下一个 token 出现的概率。
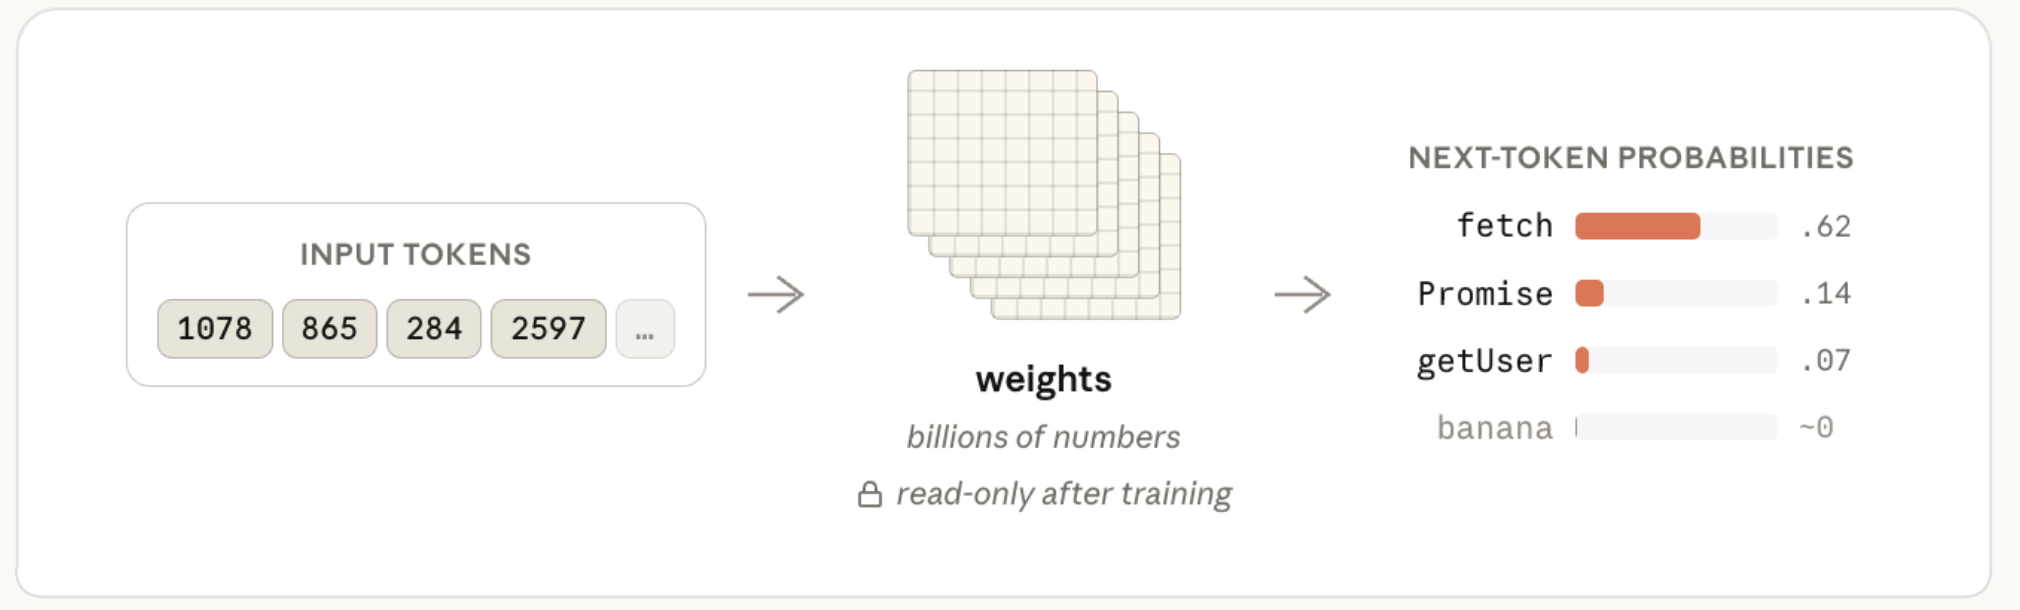
把输入 token 转换成各候选 token 概率的,是模型的权重(也称参数):数十亿个数字构成的大型矩阵。模型进行一连串矩阵计算,最终得到下一个 token 的概率分布。
每个模型的权重在训练结束后就固定了。 你在提示词、CLAUDE.md 或上下文中加入的内容都不会改变它们。所谓推理,只是使用训练完成、权重不再变化的模型。
Claude 对 TypeScript、常见框架、惯用 Go 写法等通用知识,都已编码在权重中。把真实代码或最新文档放进上下文,确实可以有效地引导它的回答,但这不是把信息“教会”了模型:信息只会影响当前请求,并不会写回权重。
因此,假如一个库在模型训练后才出现,你可以把文档提供给 Claude 使用;但当它自信地调用一个根本不存在的 API 时,那通常是权重生成了一段看起来合理的 token 序列,而不是一次查找失败。
所以,切换模型实际做的事,就是替换处理请求的那组冻结权重,同时也会改变每个输出 token 的价格。模型每次只生成一个 token,再把它接到序列末尾并重新计算下一个 token;一段 200-token 的回复,就是 200 次独立的生成步骤。
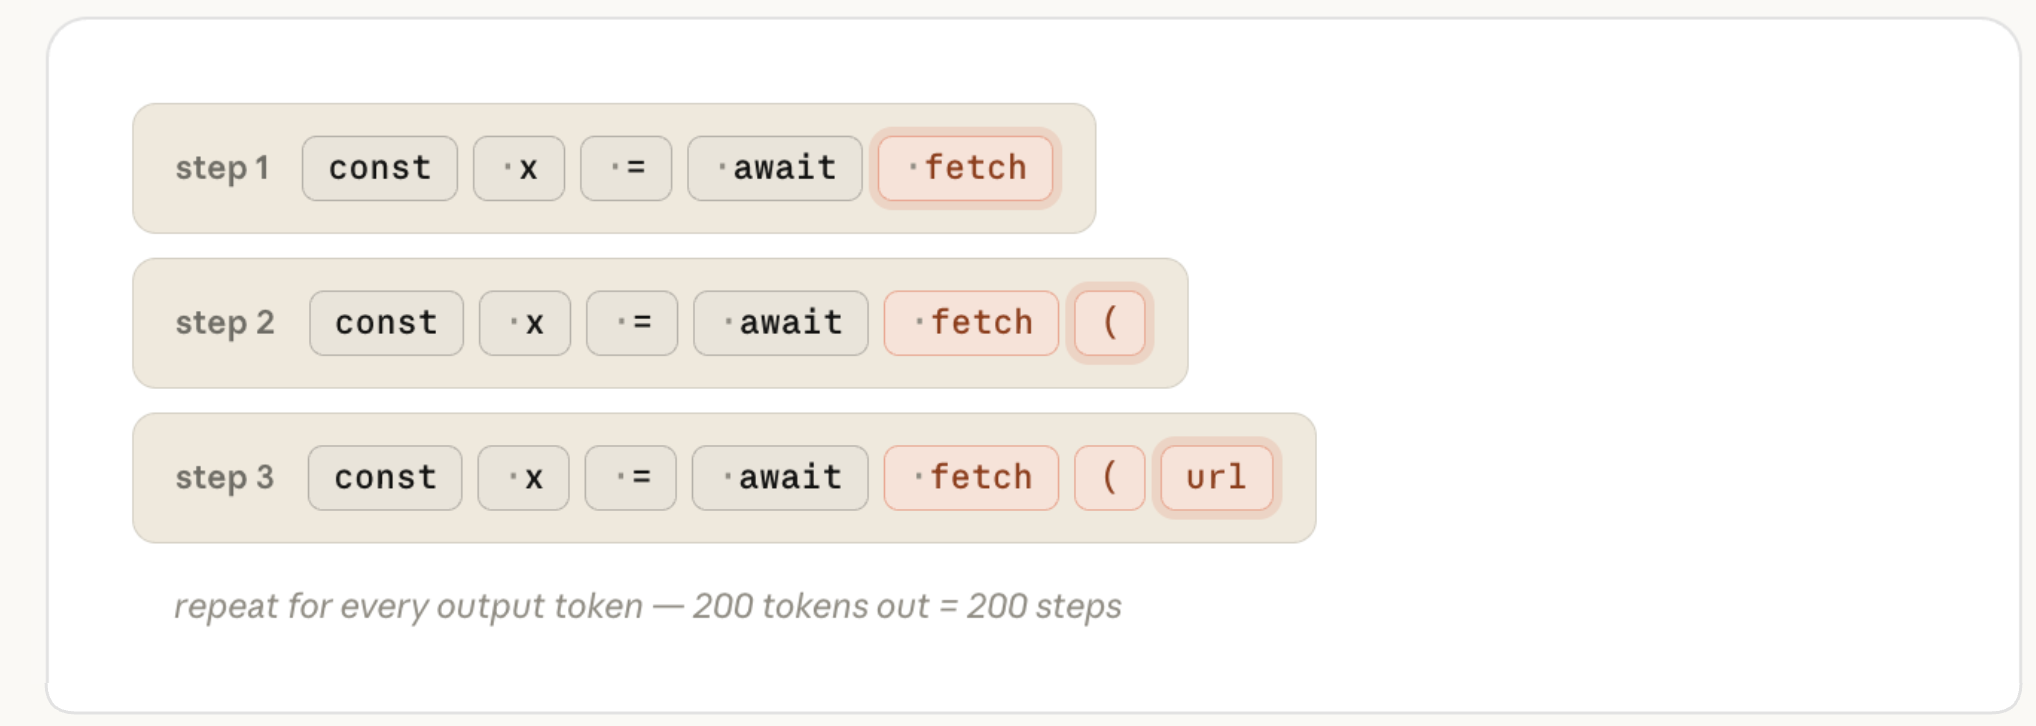
模型设置决定“由哪组权重来做”,但不直接决定会生成多少 token。相同提示下,Claude 可能因为投入的工作量不同而产生截然不同的 token 用量;这正是思考强度所控制的部分。
思考强度:决定投入多少工作
Claude 处理任务时生成的 token,主要有三类:
- 思考:行动之前及两次行动之间流式显示的推理;
- 工具调用:如
Read、Edit及其参数等结构化指令,Claude Code 会解析并执行; - 面向你的文本:计划、进度更新和最终总结。
它们都来自同一个生成循环,按同样的输出 token 方式计费。Claude 开始写代码时,先前的推理也会像已读取的文件一样,成为它后续输入的一部分。
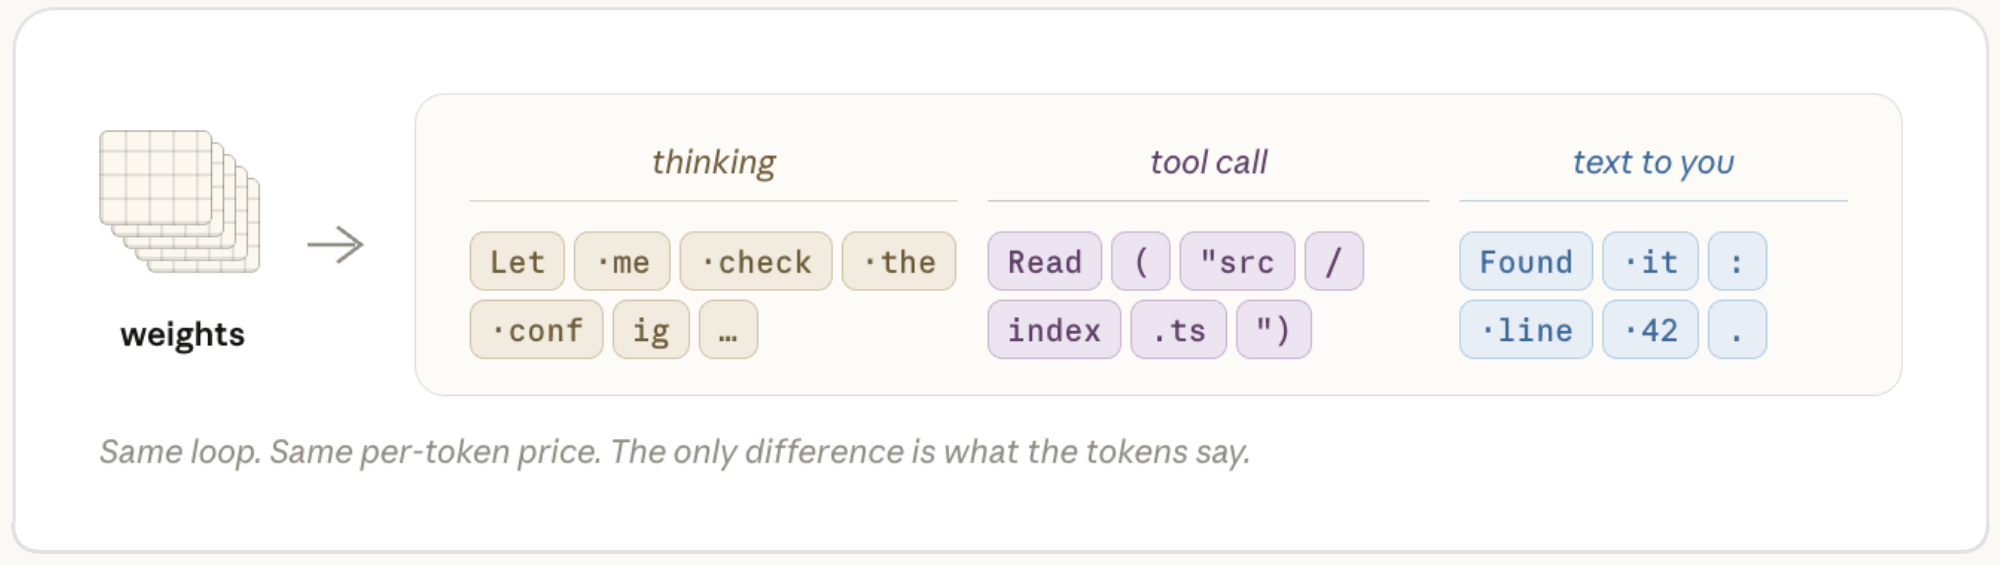
思考强度会作为请求的一部分,和提示词一起传给模型。模型在训练中已经学会了各个思考档位应采取的行为,这种行为模式同样固化在权重中。对模型而言,思考强度是另一个需要响应的输入,它会影响 Claude 在认定任务完成前,对完整性和确定性的要求。
因此,思考强度会在每一轮都被纳入考虑:更高的思考强度通常会产生更多 token,以获得更高置信度的结果。
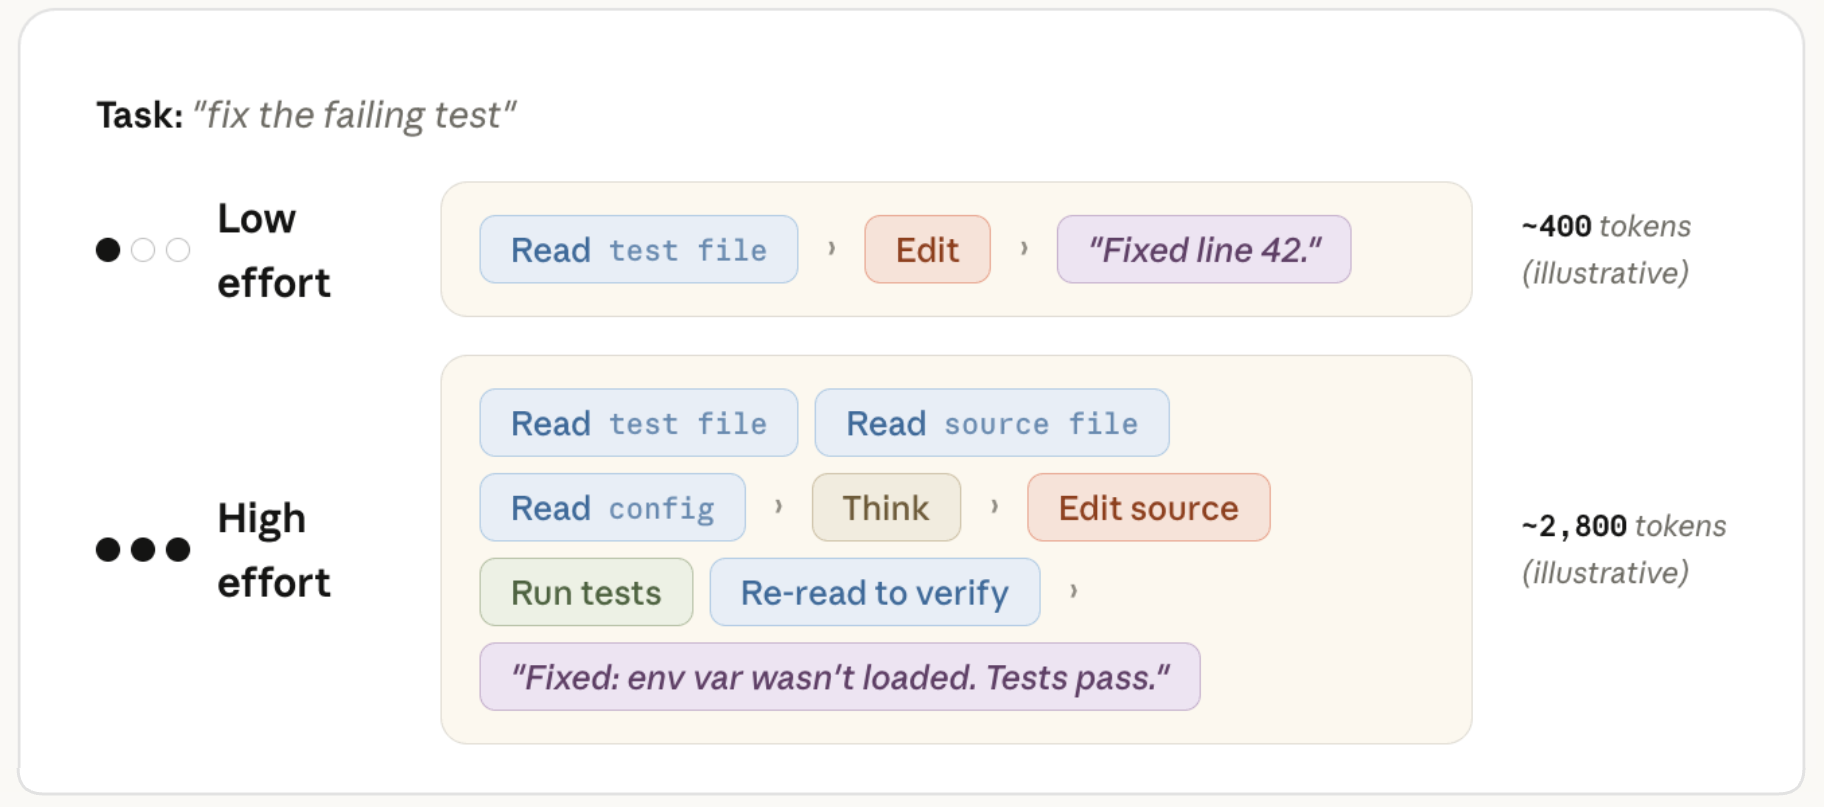
高思考强度下,Claude 往往会先制订计划,且计划的深度和覆盖面会随思考强度变化。但计划并不是不可更改的。它会根据执行结果持续更新进展和把握:例如一个包含三个假设的调试计划,若第一步已经找到了问题,那么后两个假设便可能没有必要继续验证。Claude 通常会明确说明这一点,并更新任务列表。
较高思考强度会让 Claude 更倾向于复查额外假设、验证正确性;但它一般不会为了简单任务而机械地堆高用量。训练团队会特别关注“过度思考”,因为它反而会降低效率。
如何选择思考强度
对绝大多数任务,建议先使用模型的默认思考强度。默认值旨在匹配多数用户愿意为一项任务投入的 token 规模。
把思考强度理解成一个手动覆盖开关:当你明确偏好更彻底的验证,或更快的响应时,再有意识地调节它。更好的做法是根据自己的工作类型形成总体偏好,而不是对每一个任务反复调参。
例如,官方在 Claude Opus 4.8 发布后的测试中发现:相同任务下,使用 Opus 4.8 的默认思考强度,能以大致相同的 token 数获得比 Opus 4.7 默认设置更好的结果。
Claude 出错时,到底该调模型还是思考强度?
遇到错误时,第一反应不该是马上拧某个旋钮,而应先检查给出的上下文:提示是否足够明确?Claude 是否连接了正确的工具?是否具备完成任务所需的技能?
如果一项任务按理不该需要高思考强度,问题常常出在上游:上下文、CLAUDE.md,或任务边界本身。前提是上下文已经清楚,那么就问自己一句:Claude 是没有足够认真地尝试,还是本来就不知道?
问题太难:换更强的模型
真正困难的问题适合大模型,例如隐蔽 bug、陌生领域或架构决策。若小模型即使拿到充足上下文,仍然自信地做错,大模型会更有帮助。大模型也更擅长处理歧义;而小模型更适合接收明确、可直接执行的指令。
对于能够精确描述的编辑、机械性修改,或答案已在上下文中的代码问题,应优先选择小模型。任务不需要的能力,没必要为它付费。
当 Claude 已读到所有相关信息、也清楚地尝试过,结果依然错误,这就是换大模型的信号。反过来,若你使用大模型处理的工作已经长期变得常规,降到小模型通常能提升速度、降低成本,又不会损失质量。
没有做够:提高思考强度
若 Claude 因为漏读文件、没有运行测试,或没有复查工作而出错,应提高思考强度。这在你当前选择的思考强度低于模型默认值时尤其适用。
模型、思考强度与 token 消耗
三者如何相互影响,取决于任务本身。
对于相同思考强度下的常规任务,大小模型通常都能完成。大模型会以更高的每 token 单价,执行更多验证步骤;因此,把常规工作切换到小模型,往往能省下真实成本而不牺牲质量。
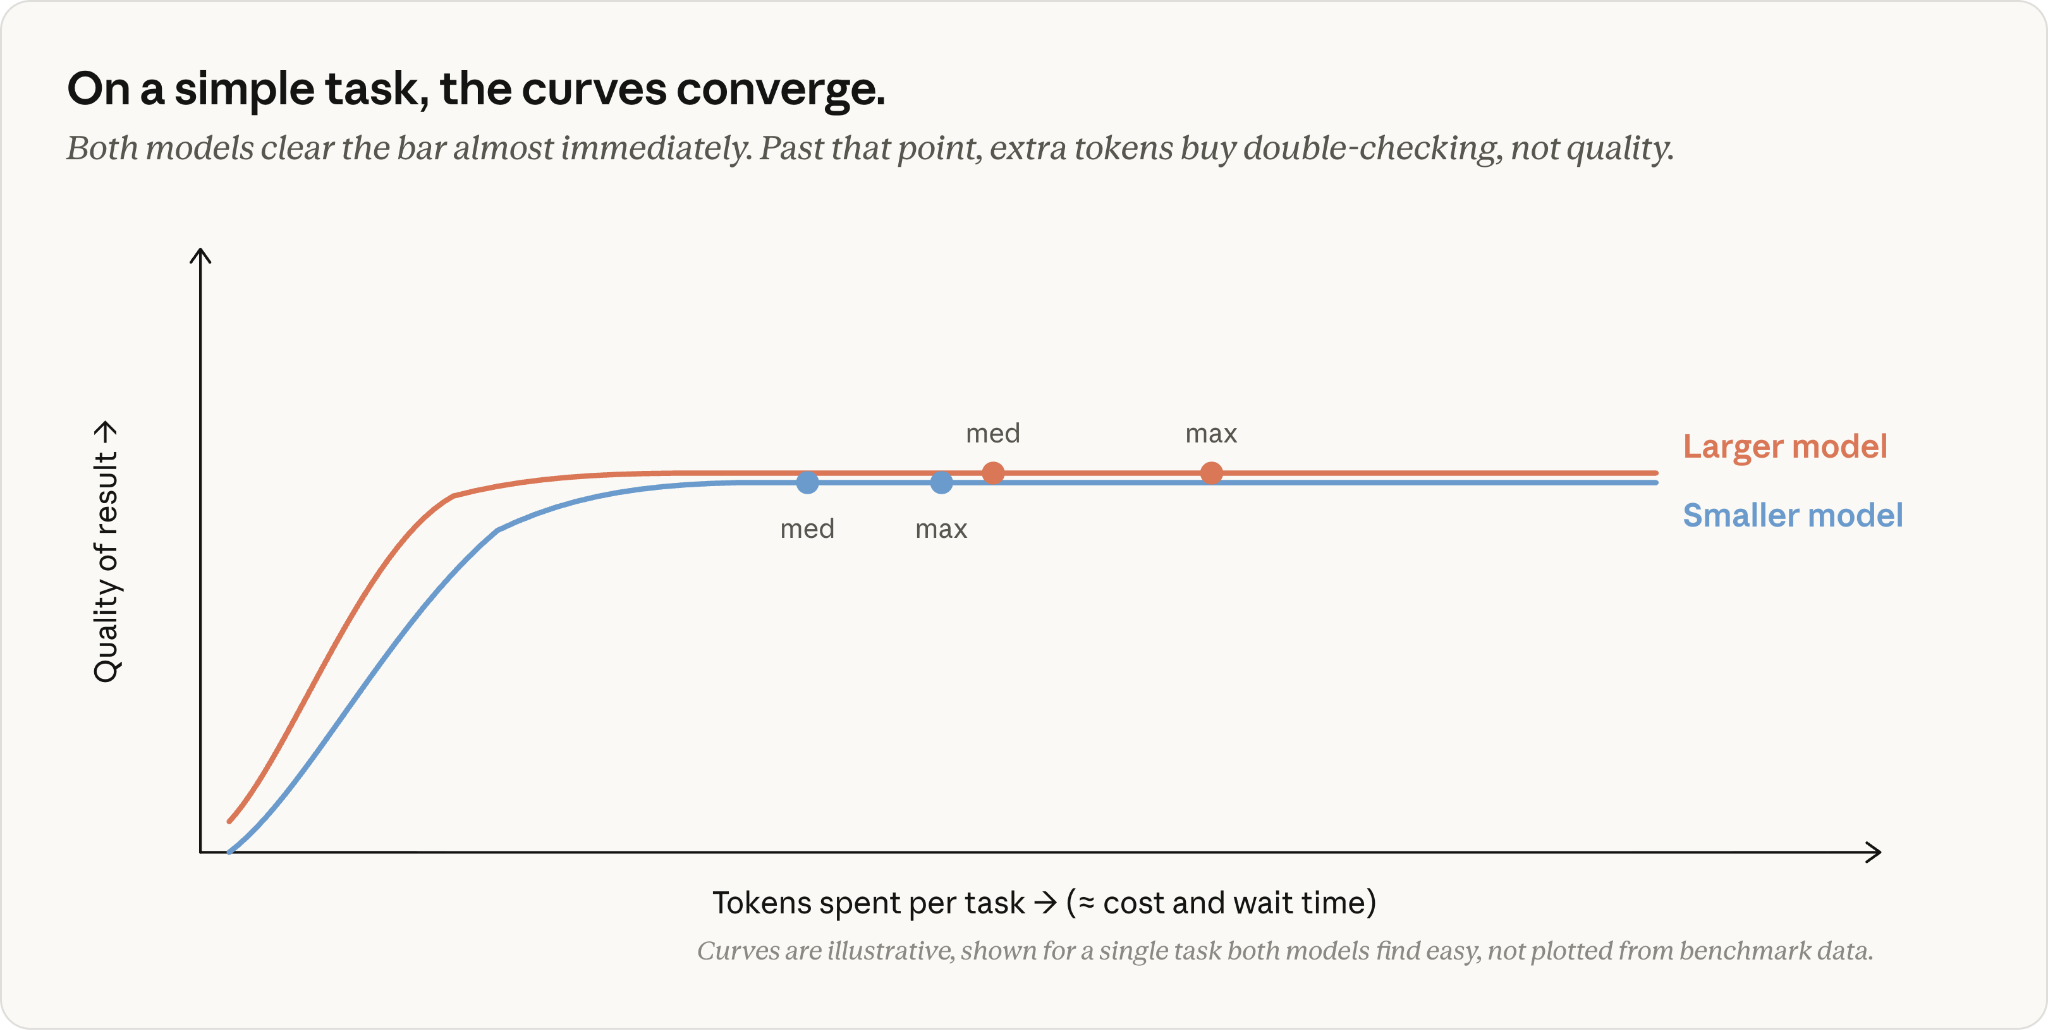
但对困难的多步骤任务,情况不同:小模型可能不断迭代,逐渐逼近自身能力边界;大模型则可能用更少步骤达到同一质量标准。虽然大模型的单 token 成本更高,但当任务确实把小模型推到极限时,单个任务的总成本反而可能更低。更关键的是,一些任务即使把小模型的思考强度调到最高,也依然无法完成。
这一点在 Fable 上尤其明显。面对长程、多步骤工作,它的领先幅度最大;官方测试显示,它能完成 Opus 和 Sonnet 在任何思考强度下都难以达到的工作。当然,它也拥有最高的每 token 成本,所以应留给确实需要它的任务。
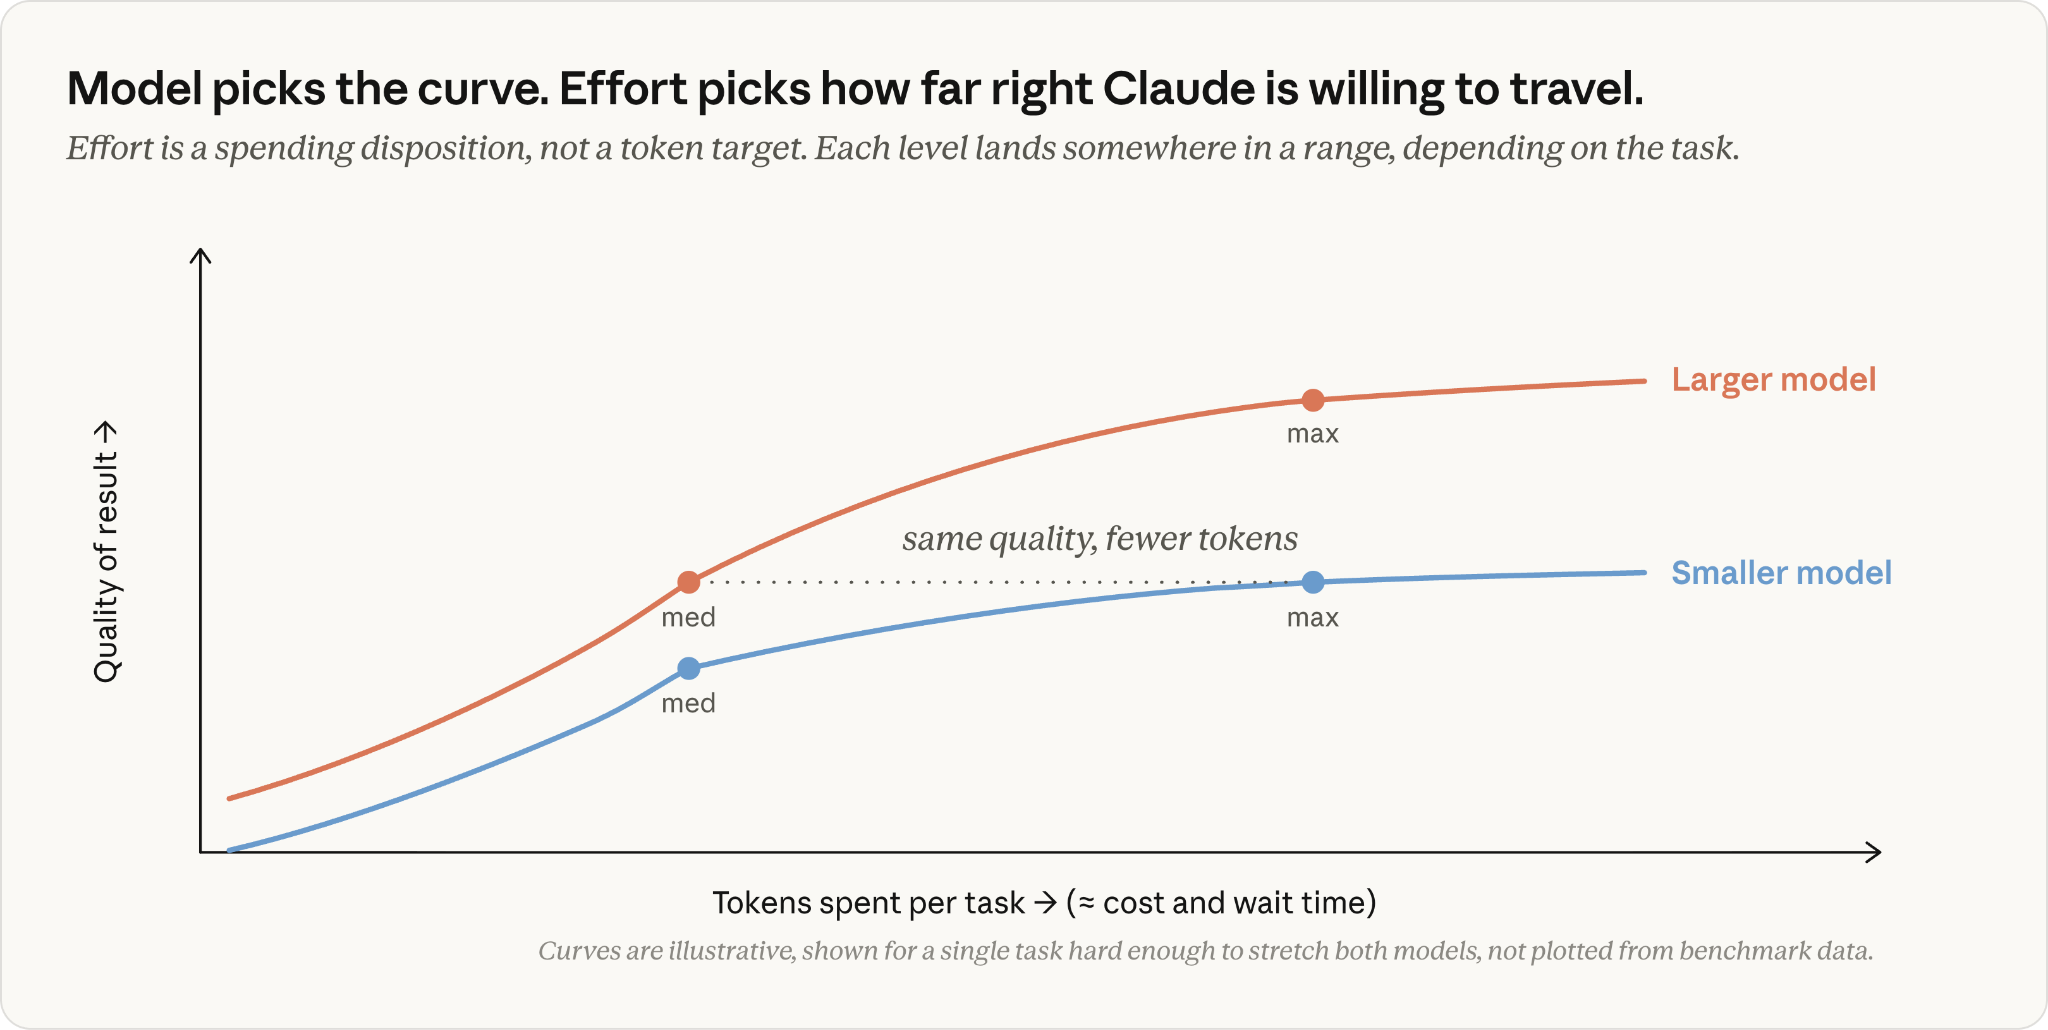
图中最重要的一点是:思考强度决定 Claude 愿意沿着曲线走多远,但不意味着它必须走到那里才能完成任务。
还有一个容易混淆的细节:思考强度会塑造 token 消耗,但不会硬性限制它。系统真正的硬上限是 max_tokens,达到后会直接截断回复;它更适合 API 开发者。相比之下,任务预算这类软性控制,或在提示中要求简洁,通常更实用:它们是模型被训练来遵循的引导,而不是撞上的一堵墙。
从默认值开始,再按问题调整
大多数时候,你无需反复考虑模型和思考强度。结果不理想时,先问“Claude 是不知道,还是没做够”,再据此调整即可。
若想进一步了解如何提高会话效率,可继续阅读《Maximizing the value of your Claude Code sessions》。
原文作者:Lydia Hallie,Claude Code 团队技术成员。