本文是 Anthropic 应用 AI 团队成员 Louis Claxton 于 2026 年 8 月 21 日发布的《The AI-Native SDLC playbook》中文翻译。原文围绕 Claude Enterprise、Claude Code 与 Claude Tag,讨论大型组织如何在保留人类判断与治理控制的前提下,逐阶段改造软件开发生命周期。
代码已不再是瓶颈
如今,组织已经能借助 AI 以一年前难以想象的速度编写代码;但围绕代码的流程,并没有以相同速度改变。
很多工程团队仍沿用原来的审批关口、评审、交接和政策。这些机制反而拖慢了 Claude Code 这类代理式编码方案本可带来的生产力提升。
软件开发生命周期(SDLC)指软件从想法走向生产的全过程。大多数组织都采用某种六阶段流程:规划、设计、构建、测试、部署和维护。传统上,每个阶段都由不同角色负责:产品经理写需求,技术架构师将其转为设计,工程师实现设计,受监管企业的 QA 团队负责验证,发布团队负责上线,运维团队监控运行中的系统。工作通过文档、工单和签字确认在这些阶段之间流转。
传统 SDLC 为了让每一步都有责任归属和控制,堆叠了许多流程。但它的设计目标,是在“写代码和实现”最耗时、最昂贵的时代最大化效率;这一前提已经不再成立。PRD、估算仪式和产品安全评审,原本都是为了让数周、数月乃至数季度的开发工作保持一致。
传统 SDLC 的控制措施还默认每一步均由人执行。创造最大价值的组织,正在围绕代理式 AI 已能完成的工作重建流程,同时确保人仍在回路中。本指南总结了 Anthropic 应用 AI 团队内部整合 Claude 的实践,并吸收了客户合作中的经验,用于加速每一阶段的开发和流程运行。
当代码不再是瓶颈、构建阶段的速度快过传统 SDLC 所允许的速度时,会发生三件事:
- 瓶颈转移到构建前后的环节,尤其是规划、评审/测试与部署;这些环节仍按人类速度运行。
- 原来的控制措施开始脱离现实,并变得难以执行。代码由人写时逐行人工审查尚且合理;当大部分 diff 由代理生成时,这种方式已跟不上。
- 治理成本会上升,因为例外情况依然需要走每周或每月才开一次的会议和委员会。
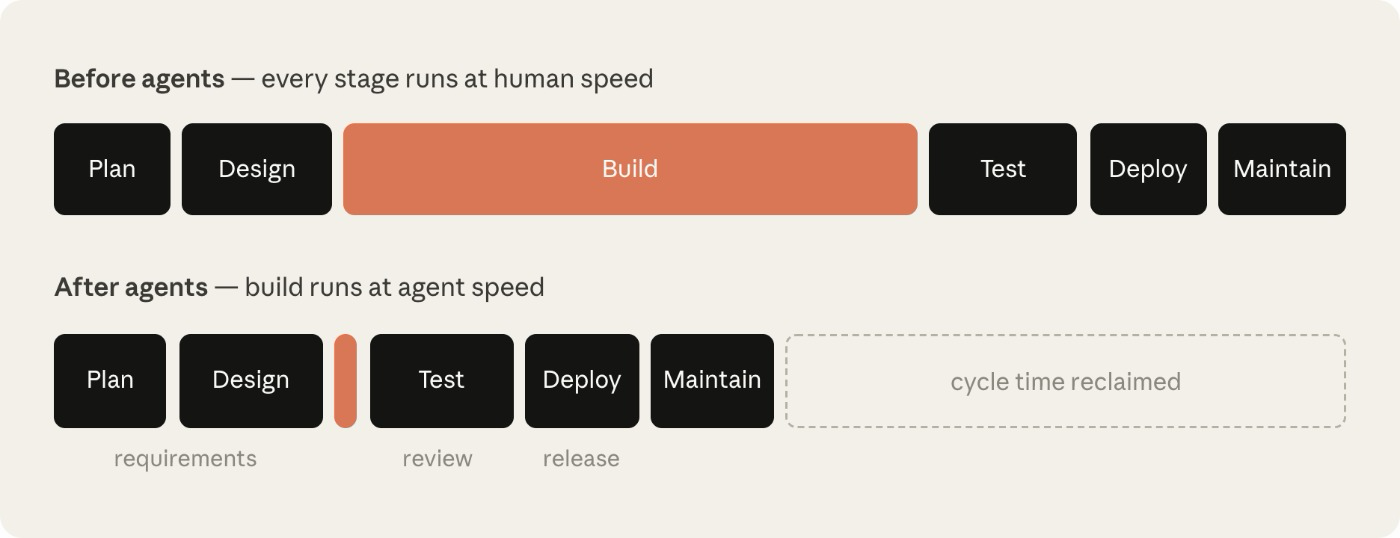
以安全团队为例:安全团队的人力规模是按人工产出配置的。当代理成倍提高代码产出,要么评审队列不断积压,要么代码在审查不足的情况下发布。受监管组织无法接受任一结果,因此安全与政策检查也必须跟上代理的节奏。
要真正释放代理式 AI 的生产力并保证其安全使用,传统 SDLC 的其余阶段也需要经历与实现阶段相同程度的转型。
什么是 AI 原生 SDLC?
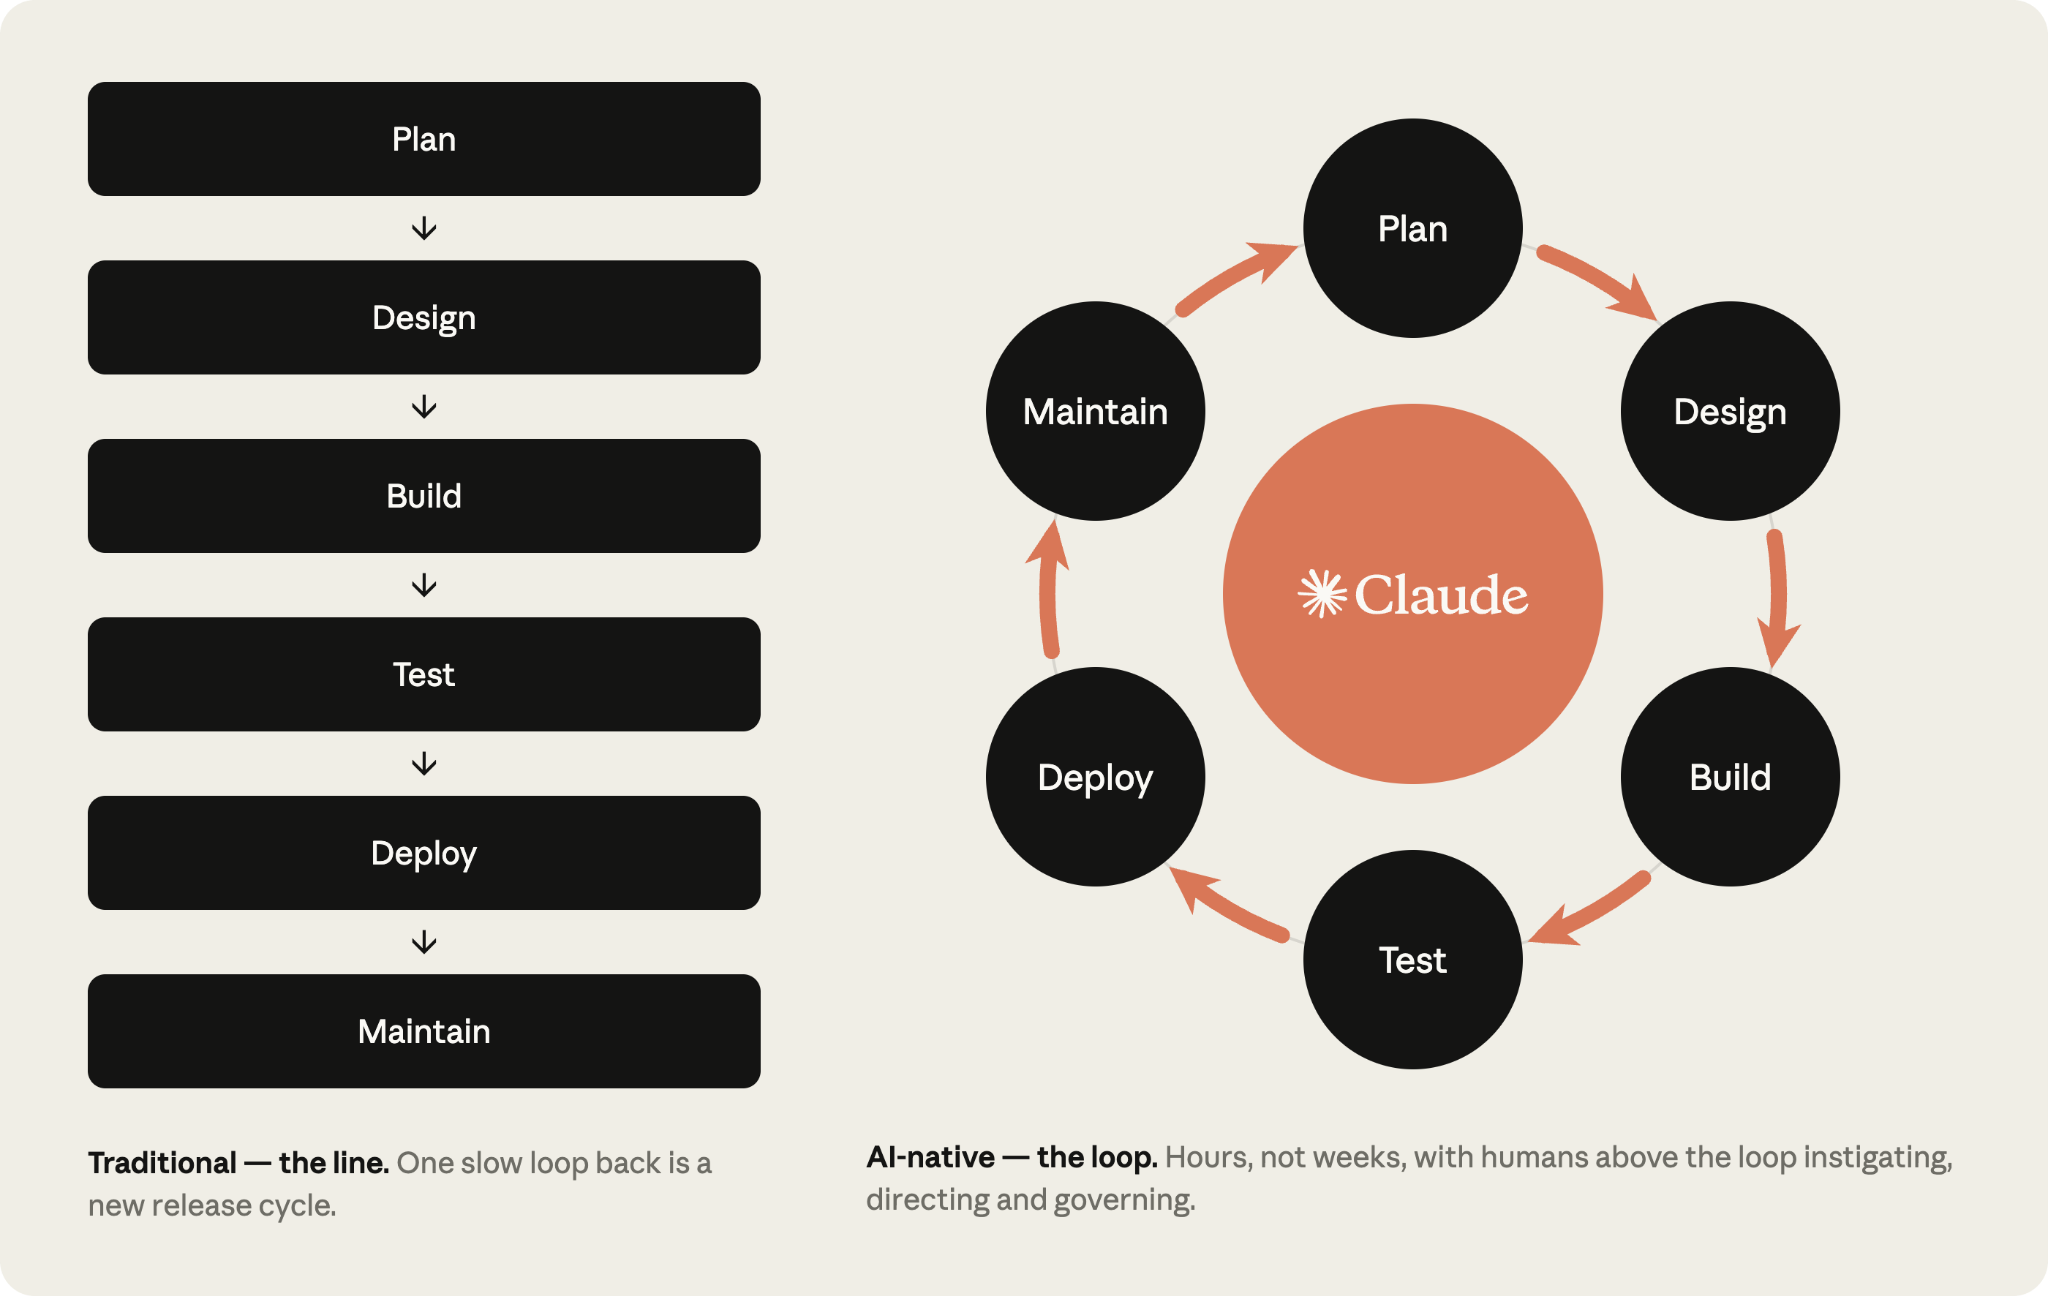
AI 原生 SDLC 是一种重新构想的流程:它保留旧流程的控制目标,但采用新的执行方式。流程不再是一条线,而是一个循环;AI 被嵌入每一个节点。它推动自动交接与后续 play 的触发,用以解决传统 SDLC 阶段间手工、笨重的交接问题。
关键转变
下表展示了 Claude 支持下,传统 SDLC 与 AI 原生 SDLC 两端的差异。多数组织会处于两者之间。
| 阶段 | 传统 SDLC | AI 原生 SDLC |
|---|---|---|
| 规划 | 委员会收集需求,经过研讨和签核,再手工写成文档 | Claude 直接综合原始痛点,写入人和机器都可读、可执行的 intent.md |
| 设计 | 分析师写规格,设计师再解析 | 需求与设计被压缩为一次与 agent 的工作会话;标准以 skills 编码,并在 Git 中版本化 |
| 构建 | 人手写测试和代码,文档往往在主要开发之后补写 | AI 生成测试与代码;机构知识维护在版本化、机器可读的 CLAUDE.md 与 skills 中 |
| 测试 | QA 在开发末期测试,缺陷通过工单返还 | AI 在开发中持续运行测试、审查和评测;失败会形成可追踪的工件 |
| 部署 | 发布团队手工协调、逐项检查和审批 | CI/CD 以确定性控制与人类授权关口执行;代理在边界内准备、诊断和提出变更 |
| 维护 | 监控、事故、工单和开发流程相互割裂 | 监控信号触发诊断,生成下一份 intent.md,再进入同一闭环 |
右栏贯穿始终的是“已提交的工件”。每个阶段结束时都会把一个工件写入版本控制:包括 intent.md、spec.md、plan.md、代码 diff 及测试、附带审查结论的 PR、以及事故记录;下一阶段从读取它开始。早期阶段主要使用 .md,因为产品负责人和 agent 都能读、都能基于同一文件行动。从构建开始,工件变为代码及其记录。提交链本身也是审计轨迹:谁提出了什么、代理产出了什么、谁批准了它。
所有需要判断的决策仍由人承担责任。在代理式 SDLC 中,人类的注意力会随着必须审查的工件一起移动。
Plays
这些 play 是手册的核心,按六个非线性阶段组织:规划、设计、构建、测试、部署、维护,合起来覆盖完整生命周期。
每个 play 都包括:变化是什么、如何开始、具体实施步骤、治理注意事项,以及如何衡量它是否有效。
这些步骤是模块化的。组织可以依据自身需求,在不同时间优先改造不同阶段。每个 play 都在“前置条件”中标明依赖关系,依赖图也会进一步说明它们。
一个阶段以提交某项工件结束,而该提交启动下一阶段:被接受的 intent.md 触发需求与设计;获批的 spec.md 触发计划模式;合并的 PR 触发流水线;生产中控制带被突破时,则会写下下一份 intent.md,循环继续。
起初,可手动提示每一步;最终目标是让每一份被接受的工件自动触发下一个关口。人类注意力集中在关口,审查 agent 标出的内容,而不是从头启动每个阶段。
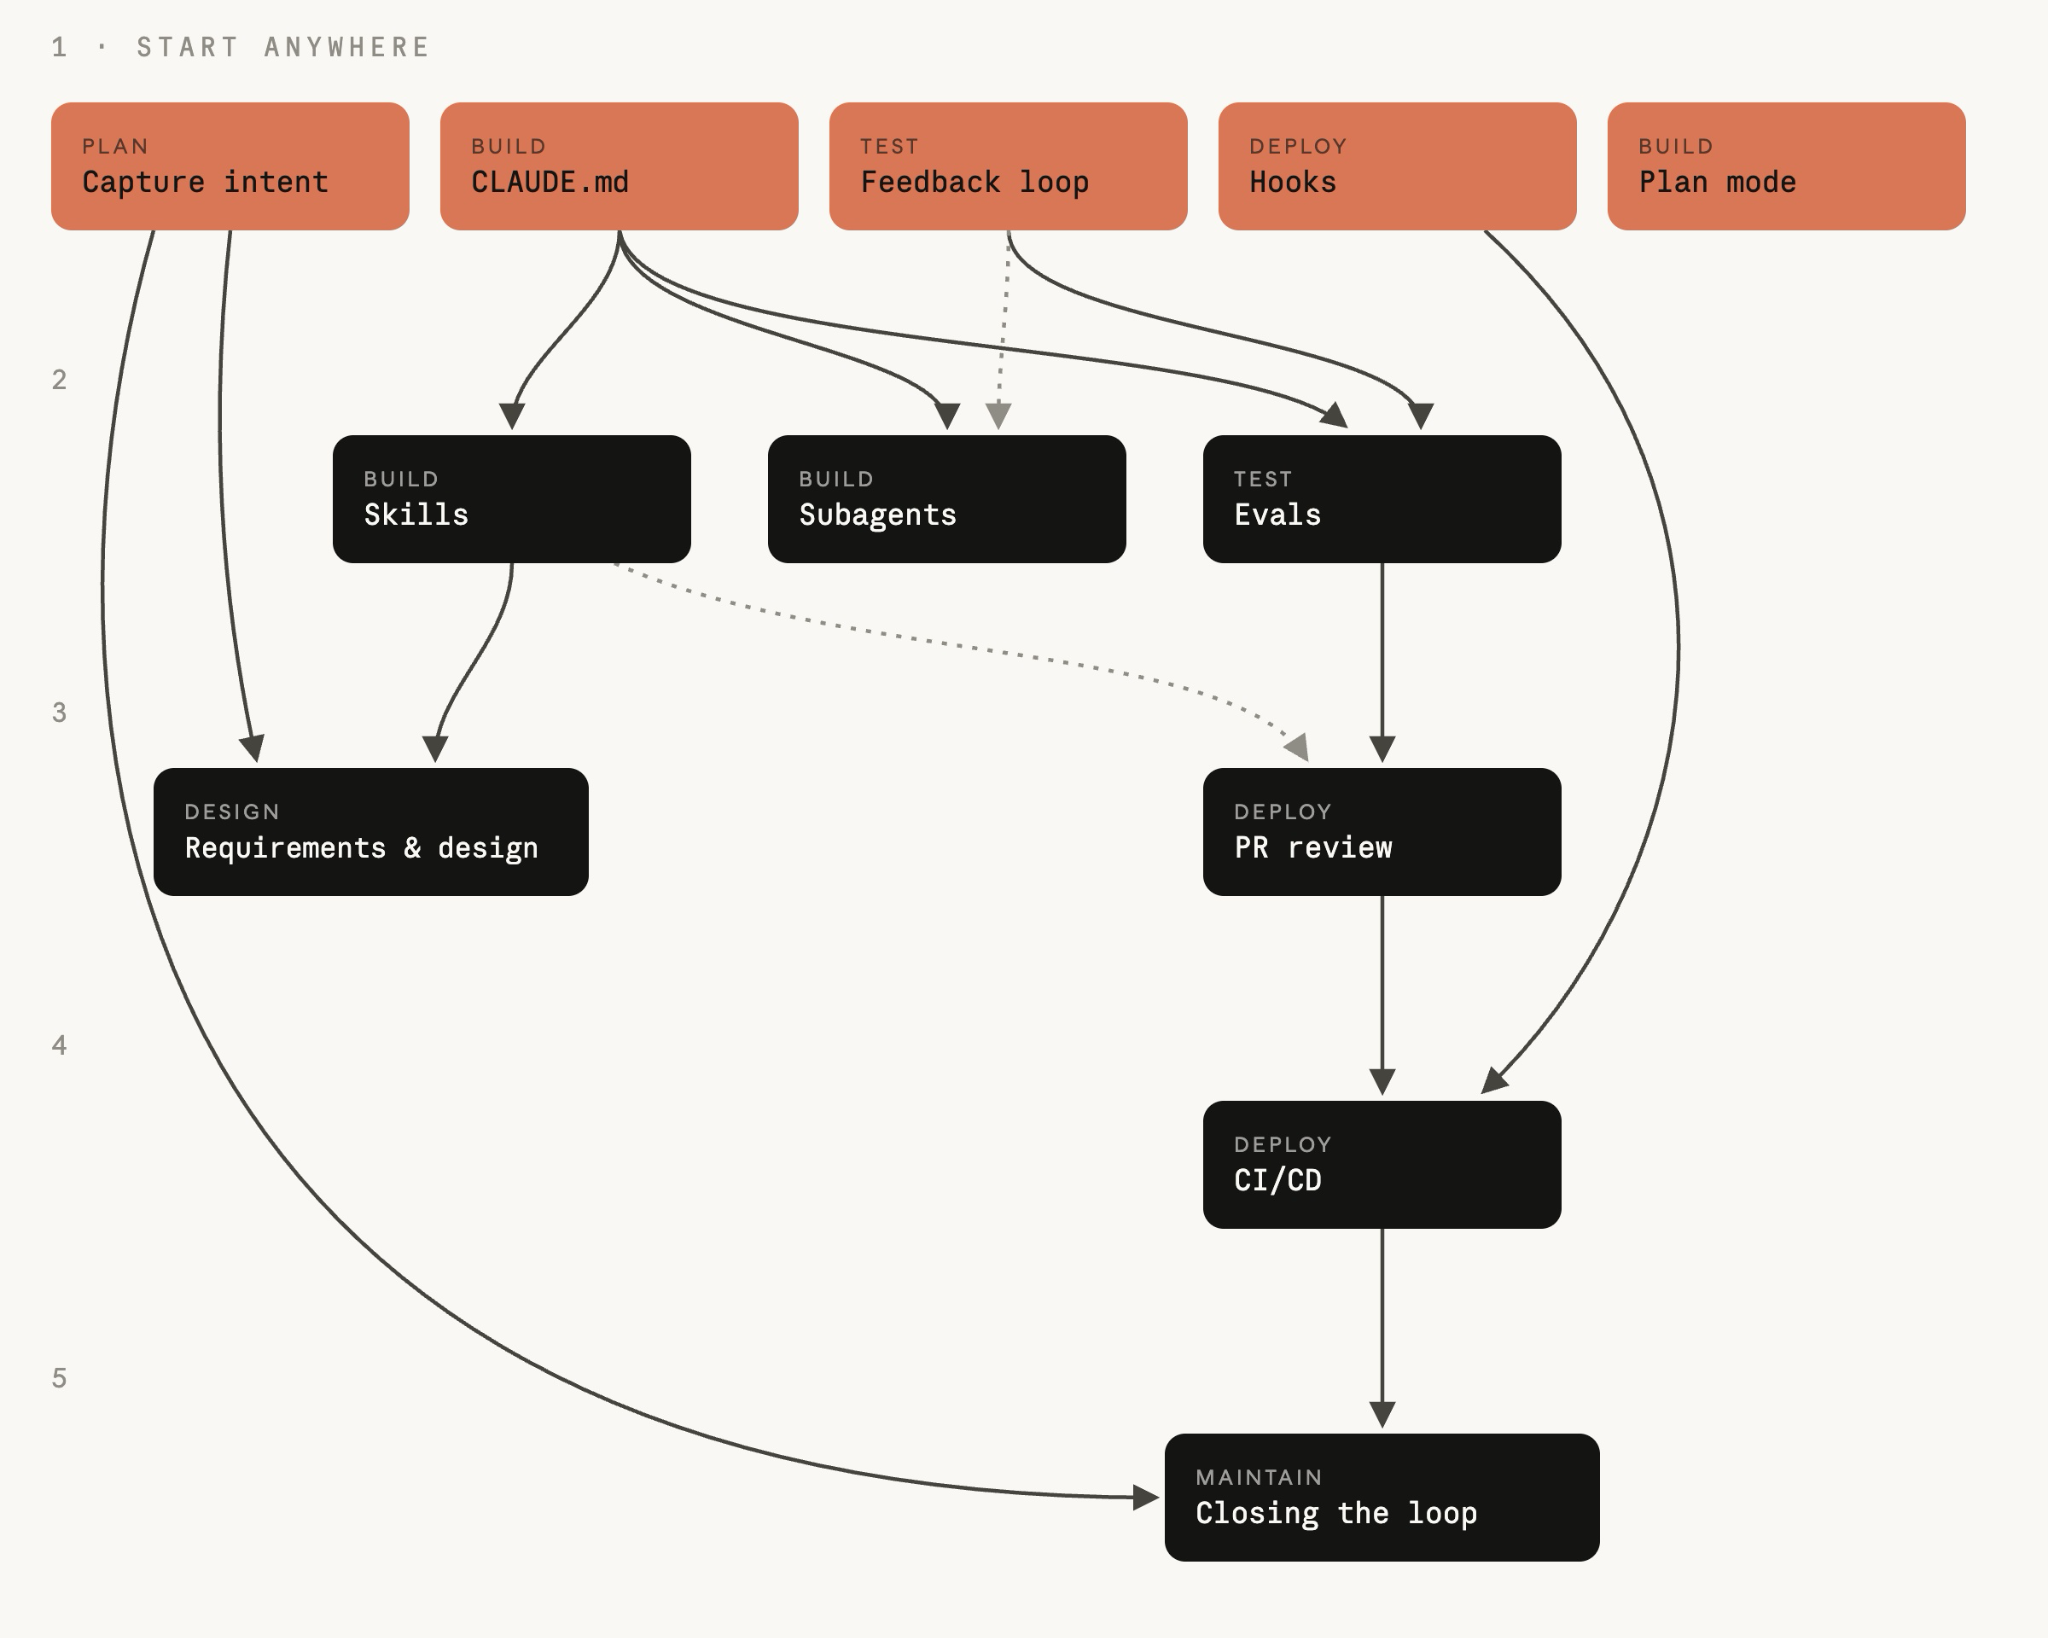
图中列出了各 play 所属阶段;箭头表示推荐采用顺序,两者并不相同。从任一“黏土色”的 play 开始即可,因为没有箭头指向它,意味着没有前置依赖。对于其他 play,应先采用所有指向它的 play。
阶段 1:规划
将想法记录为 intent.md
启动软件开发流程的 intent.md 可以从多种路径进入:某个人提出想法、有人创建工单,或监控告警暴露出事故(见阶段 6:维护)。
当想法来自个人时,他或她可与 Claude 头脑风暴,形成一份 Markdown 原型规格。在传统 SDLC 中,同一个人随后还得说服产品团队成员一起、或代为把想法正式写下来。
Claude 生成的原型规格既可由人阅读,也受版本控制,并能立刻被下一阶段消费。它被保存为 intent.md。
无论意图源于事件触发还是 agent,后续步骤相同:产品负责人先审阅并修正 agent 撰写的 intent.md,然后才提交。
这是一项平台或工程团队一次性完成的搭建工作。技术成员需要建立存放 intent 的空间,并决定谁可以写入,因为贡献者可能来自组织各处。
仓库建立后,不熟悉 Git 的贡献者不必直接使用 Git。通过版本控制系统(例如 GitHub)的连接器,Claude 可在 claude.ai 或 Cowork 中代他们提交 Markdown 文件。
如何执行
- 提出者用自己的语言向 Claude 描述问题:今天做不到什么、谁受影响、更好的状态是什么、哪些内容不在范围内。无需正式措辞。
- 不断讨论,直到想法具体。Claude 会像业务分析师一样追问范围、用户、约束和成功标准。
- 要求 Claude 按组织模板写成
intent.md。技术成员可将模板编码为 skill,并由负责人签核;它可覆盖问题、预期结果、受影响用户与系统、约束和未决问题。 - 提出者修正 Claude 的误解。
- 将
intent.md提交到共享空间。作者与时间戳进入记录,产品负责人从这里接手。
示例:intent.md
# Intent:理赔状态自助查询

作者:J. Ortiz(理赔运营)。状态:草稿。

## 问题

客户会致电呼叫中心询问理赔进度。
处理人员约三分之一的通话时间都花在仅查询状态的问题上。

## 预期结果

客户可在门户中看到理赔状态、下一步及预计日期。

## 受影响的用户与系统

理赔处理人员、门户团队、理赔核心 API。

## 约束

门户会话中不新增 PII;仅使用现有认证。

## 未决问题

第三方损失理算师是否也需要访问权限?
治理注意事项
证据就是已提交的 intent.md:其中包含作者、时间戳和完整修订历史,并记录在 intent 空间的 Git 历史中。产品负责人审批;把 intent 送入阶段 2“设计”的接受或拒绝决定,会作为合并或关闭评审被记录下来。
阶段 2:设计
需求与设计
产品负责人批准后,Claude 会基于被接受的 intent.md 产出需求与设计规格。这一步会受组织针对品牌、安全、合规和 UX 的 skills 引导。
产品负责人审阅这份规格,但不亲自执笔。目标是形成工程团队可据以规划的规格,并标出需要关注的部分。
前端工作是最直观的例子。intent.md 被接受后,产品负责人可根据它在 Claude Design(测试版)中制作设计稿、迭代,再导出到 Claude Code 实现。
如何执行
- 产品负责人打开一个加载了组织 skills 的会话,并附上
intent.md。 - 提示词应指向
intent.md、说明约束并要求标出顾虑。开始时手动运行;之后把它固化为组织级 slash command。再进一步,可把 intent 空间中intent.md的接受设为触发器:合并时运行非交互任务,加载组织 skills,生成spec.md并作为 PR 提交。阶段 5“部署”的 CI/CD play 负责相关管线。 - 同一产品负责人依据最初想法审阅规格:它是否解决了已陈述的问题?
intent.md中的未决问题是否已回答或被带入后续? - 优先处理标记出的顾虑,因为那正是分析师本应升级的问题。产品负责人应先与对应政策负责人逐项解决,再交给工程团队。
- 将
spec.md与intent.md一起提交。文件对记录“提出了什么”和“做了什么决定”。 - 产品负责人决定规格与 intent 是否进入构建;对于组织划为高风险的事项,咨询技术负责人。这个决定始终由人作出;接受规格才启动阶段 3 的计划模式。
示例提示词
阅读附带的 intent.md,并为将其接入现有代码库产出一份需求与设计规格。
应用可用的 skills,使计划符合我们的品牌规范、安全政策和 UX 标准。
完整写入 spec.md,交付给工程团队即可执行。清楚描述所有顾虑,尤其是
无法同时满足相互冲突政策的地方。
治理注意事项
政策不再在数周后的评审中才被发现,而是在写规格时就被读取与应用。组织 skills 作为规格的约束。规格、生成它的提示词以及当时生效的 skill 版本都记录在版本控制中。产品负责人签核规格,并将标出的顾虑分派给指定政策负责人。
阶段 3:构建
默认从 Claude Code 的计划模式开始
工程师在 Claude Code 中以计划模式启动会话,提供阶段 2 已批准的 spec.md,让 Claude 通过提问与工程师一起迭代计划,直到工程师满意。
如何执行
- 工程师在计划模式启动 Claude 会话。
- 提供
intent.md与spec.md,要求 Claude 给出实现计划:列明要改的文件、实施顺序和证明变更正确的测试。 - 追问计划:它可能破坏什么?哪一步风险最高?它没有选择哪些替代方案,为什么?
- 不断迭代,直到一个从未见过该对话的工程师,也能仅凭计划完成实现。
- 将获批计划提交为
plan.md。它加入审计轨迹;阶段 5 的 PR 评审 play 会将最终 diff 与它比对。 - 接受计划后让 Claude 实现。计划扎实时,实现通常只需一次完成。
- 实现一旦偏离计划,应在同一提交中更新
plan.md;可考虑用 hook 强制两者同步。
示例:plan.md
# Plan:理赔状态自助查询(来自 2026-06-02 的 intent.md)

## 变更文件

portal/src/claims/StatusPanel.tsx(新增)、claims-api/routes/status.py、
claims-api/tests/test_status.py

## 实施顺序

1. 在现有认证后添加状态接口。
2. 让面板调用该接口。
3. 接入门户导航。

## 风险

claims-core API 限制为 50 rps;面板必须缓存。

## 证明

test_status.py 覆盖四种理赔状态;截图与获批设计稿一致。
治理注意事项
设计评审发生在生成代码之前,此时改变方向只需修改文档。计划模式本身也强制这一点:在工程师接受计划前,Claude 不能编辑文件。计划及其修订记录了谁接受了它。日常变更由工程师批准;组织认定为高风险的事项交由技术负责人或架构师。
在自动模式中使用 Claude Code
Claude Code 也能在自动模式运行:工程师批准并迭代好计划后,Claude 会应用每项变更,而无需逐次编辑确认。随着后续 play 的护栏逐渐成熟——经过打磨的 CLAUDE.md、编码政策的 skills、阻止不安全操作的 hooks,以及 Claude 可运行的测试套件——自动接受会成为日常工作的默认方式:明确的 spec.md、很小的影响面,以及已有测试覆盖的代码。
关注点会从“用户盯着 agent 做编辑并审查每个动作”转向“在更长的自主会话后审查工件”。自动接受也能借助 worktree 在个人和团队之间形成并行,是让 SDLC 自主运行、并如阶段 6 所述闭环的基础。
CLAUDE.md
CLAUDE.md 为 Claude 提供新成员需要的上下文:约定、命令、架构与团队最常遇到的错误。原本藏在人脑和 wiki 中的知识,变成 agent 每个会话开始时都会读取的文件;全团队共同维护,并在每次犯错后持续迭代。
如何执行
- 在仓库中运行
/init,让 Claude 根据发现生成初始CLAUDE.md。 - 将其删减为新成员第一天真正需要的内容:构建、测试、lint 命令,重要约定,以及 Claude 总会犯的错。
- 将根目录的
CLAUDE.md提交到 Git,让整个团队共享一个版本,并像代码一样审查改动。 - 可采用一条工作规则:Claude 第二次犯同样的错时,就把修正写进
CLAUDE.md。 - 保持在一页以内。Claude 在会话开始会全部读取;过时内容只会无谓占用上下文。
示例:CLAUDE.md
# 支付服务

## 命令

- 构建:make build
- 测试:make test(单元),make itest(集成,需要 Docker)
- Lint:make lint(CI 会运行;推送前修复)

## 约定

- Java 21、Spring Boot 3;不新增 Lombok。
- 金额始终使用 BigDecimal,绝不使用 double。
- 每个接口都要在 src/itest 中有集成测试。

## 架构

- api/ 存放 REST 控制器,core/ 存放领域逻辑,adapters/ 负责外部系统。
- Kafka 事件定义在 schemas/;绝不编辑生成类。

## Claude 容易犯的错

- 不要升级依赖版本;由平台团队负责。
- 遗留的 v1/ 包已冻结;改动应放在 v2/。
治理注意事项
CLAUDE.md 受版本控制,因此 agent 遵循的指令可审查、可审计。团队约定通过该文件应用,对它的改动会记录在 Git 历史中,代码所有者在 PR 评审中批准这些改动。
将机构知识编码为 skills
Skills 让组织的机构知识可以被实际执行:指令明确、可版本控制、可广泛应用,并会在政策改变时集中更新。一条经验法则是:必须始终一致应用的机构知识,写成 skill;属于组件的内容放在 CLAUDE.md 或提示词中,不要写成 skill。
如何执行
- 选取一项当前执行不一致的知识,例如安全标准、API 设计约定或品牌规则。
- 把它写成 skill:一个包含
SKILL.md的目录,frontmatter 说明何时触发,正文说明做什么。工程师以政策负责人的权威来源为基础编写,可用 Claude 协助。 - 将 skill 放在仓库
.claude/skills/<name>/,随代码发布;或通过 plugin 在全组织分发。 - 测试触发:用不同说法要求 Claude 完成相关任务,确认 skill 每次均会加载。
- 政策变更时更新 skill,并让政策负责人签核。
- 工程师会在下一次会话中自动获得新版本。
示例:.claude/skills/secure-api-review/SKILL.md
---
name: secure-api-review
description: 应用 API 安全标准。创建或修改外部接口、审查 API 代码、
或生成 OpenAPI 规格时使用。
---

# 安全 API 评审

创建或修改 API 接口时:

1. 认证:每个接口都需要网关 JWT;除 /health 外不允许匿名路由。
2. 输入校验:按 OpenAPI schema 校验请求体,并拒绝未知字段。
3. 审计:每个改变状态的接口都要发出包含操作者、操作、实体和时间戳的审计事件。
4. 数据分级:schema 中标记为 pii 的字段绝不出现在日志或错误信息中。

运行 scripts/check-endpoints.sh,并在总结中附上输出。
治理注意事项
Skill 是一种控制,但属于建议性控制。它会让 Claude 更可能在写代码时遵守政策,却无法强制每次会话都遵守。必须毫无例外成立的政策,需要在 skill 背后增加确定性措施,例如阻止动作的 hook,或在 PR 中重新检查政策的评审 pass。skill 让违规变少;hook 让违规几乎不可能。skill 调用会记录在会话 trace 中,政策负责人像审代码一样审查 skill 变更。
将 hooks 作为构建时护栏
Skill 是建议性控制,hook 则是其背后的确定性层。Claude 在实现中大多数动作是编辑文件和运行 shell 命令,因此 hook 在构建阶段会最常触发。
构建阶段 hook 可以:阻止编辑受保护路径(如生成类或冻结包);在文件编辑后运行格式化与 lint,避免风格漂移;以及阻止凭据进入 diff。
任何必须无例外成立的 skill 政策,都应有 hook 支撑。hook 会在每个匹配动作时运行,因此构建阶段的 hook 应快速、且仅关注改动文件。全量测试等较重检查适合放在提交或 PR 阶段。
需要人类批准的 hook,应放在阶段 5“部署”的关口:若在构建中要求人批准,会使人重新回到所有并行会话的关键路径上。
并行会话与子代理
一位工程师可同时推动多条工作流。
并行会话是另一个完整 Claude Code 实例,在独立的 Git worktree 中处理独立任务。各会话彼此不知道对方存在,唯一共享者是负责引导和审查它们的工程师。
子代理 则在一个会话内运行,是带有独立上下文窗口和工具限制的定向助手;它适合跨多个任务反复出现的工作,例如验证应用是否按预期运行。
并行会话提升一位工程师同时在办任务的数量;子代理帮助每个会话保持聚焦。工程师的职责是引导与审查全部输出。
如何执行
- 依据阶段 3 的计划,将工作拆为修改不同文件的任务。共享文件的任务在一个会话里顺序执行。
- 每个并行任务使用自己的 worktree,例如一个终端运行
claude --worktree feature-auth,另一个运行claude --worktree fix-rate-limit。worktree 是拥有独立分支的独立检出,避免会话互相冲突。 - 以两三个会话开始较合理。实际上限是人能认真审查多少工作流;只有评审跟得上时才增加会话。
- 将重复工作封装为定义在
.claude/agents/的子代理:每个 Markdown 文件写明名称、何时使用和可触及的工具。例如代码简化器、验证器、研究员。把定义提交进 Git,让团队共享。
示例:.claude/agents/verifier.md
---
name: verifier
description: 在会话报告完成前运行应用,并检查改动是否正常
tools: Bash, Read
---

启动应用:make run。操作已改动的行为以及两个最相邻的流程。
报告运行了什么、看到了什么,以及所有不符合 plan.md 的行为。
不要修复;只报告。
治理注意事项
会话越多,输出越多,因此控制必须来自仓库配置。仓库中的 hooks 与权限设置对所有会话生效;会话的行为有日志,并归属到启动它的工程师。
给 Claude 一个反馈回路
始终要给 Claude 自证工作的途径:测试、构建或截图 diff 均可。会话在工程师看到之前自行检查并修正错误。
不要把反馈回路与验证器子代理混为一谈。反馈回路贯穿任务、会运行多次;验证器子代理则是在会话自认为完成后,以一个新的上下文窗口执行最终检查的一种打包方式,避免结论被最初实现的假设影响。
如何执行
- 若今天检查工作需运行一串命令和依赖环境知识,就把它包装成一个命令,如
make test或npm test,并让失败时返回非零。 - 在
CLAUDE.md的“命令”部分列出每个命令及健康输出示例。 - 给出量化目标,以便 Claude 自行检查:例如“
test_status.py全绿”“截图与获批设计稿一致”“接口返回新增字段且状态为 200”。 - 修 bug 时先写能复现 bug 的失败测试,运行并确认它因预期原因失败;提交该测试。之后才让 Claude 在不改测试的前提下使其通过,并用 hook 阻止修复任务中编辑测试文件。修复前已存在、且 agent 无法改写的测试,才是 bug 消失的证据。
- UI 工作用视觉检查闭环。给 Claude 浏览器或截图工具与设计稿,让它反复实现、截图、比较和调整;两三轮很正常。
- 把验证纳入“完成”的定义,写进
CLAUDE.md;报告任务完成前运行测试并展示输出。 - 反馈回路本身也需要保护:修代码的 agent 不应能削弱检查。可用 hook 阻止修 bug 时编辑测试文件;替代办法是在评审中拒绝任何改动测试的 diff。
示例:CLAUDE.md 中的验证块
## 验证工作

- 构建:make build(必须以 “Build succeeded” 结束)
- 测试:make test(全部通过;绝不跳过或删除失败测试)
- Lint:make lint(零告警)

报告任务完成前运行以上三项,并粘贴输出。
若测试失败,修代码,不修测试。
阶段 4:测试
在 CI 中持续运行评测
评测是 AI 原生的阶段门禁 QA:只要 agent 配置变化,就运行一套测试,判断换模型或改提示词后,agent 是否仍以原来的标准完成工作。
评测应视作持续演进的套件。随着模型变强,曾经具有区分度的案例可能不再有效;维护阶段出现的新问题应不断补充进来。
有些团队会选择按固定周期离线运行,而不是每次改动都运行。下面步骤适用于持续评测。
如何执行
- 平台工程师从近期真实工作中收集 20 到 50 个任务及其预期/已接受结果。
- 将每项任务写成 eval:提示词加上可接受结果的检查(测试通过、lint 干净、行为未变、政策遵守)。
- 对
CLAUDE.md、skills 或 hooks 的任意变更,都在 CI 中按计划和非交互方式运行套件;这些配置驱动 agent,理应获得与代码一样的回归测试。 - 以结果作为配置变更门禁。导致通过率下降的 skill 改动,合并前必须审查。
- 每次生产事故都由所属团队写成一项 eval,并作为回归测试长期保留。
示例:.github/workflows/agent-evals.yml
name: Agent evals
on:
  pull_request:
    paths: [CLAUDE.md, '.claude/**']
  schedule:
    - cron: '0 2 * * *'
jobs:
  evals:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - run: npm install -g @anthropic-ai/claude-code
      - name: 运行评测套件
        env:
          ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
        run: |
          for eval in evals/*.json; do
            claude -p "$(jq -r '.prompt' $eval)" \
              --allowedTools "Read,Edit,Bash(make test)" \
              --output-format json > result.json
            ./evals/check.sh "$eval" result.json
          done
治理注意事项
Evals 给 QA 一道能跟上 agent 产出的关口。通过率阈值被实施为合并检查;每次运行都有日志,结果可长期对比;拥有配置变更的团队负责批准它。
阶段 5:部署
将 AI 放进 PR 评审回路
Claude 既能给出评审,也能接收评审。它可以按组织政策审查传入 PR,并处理自己 PR 上的评审意见。这让工程师在 PR 评审时更专注于行为,归根结底是在判断意图与风险。
如何执行
- 托管 Code Review 服务是最快的起点:管理员启用服务并选择仓库。当需要控制流水线,或希望 API 调用通过自有云协议路由时,可用
claude-code-action在 CI 内运行评审。 - 技术负责人于仓库根目录写下
REVIEW.md,将组织关心的 pass 分为:bug 与逻辑错误;安全与漏洞;以及针对规格(需求阶段的spec.md)、实现计划(计划模式的plan.md)与设计原则的合规性。它还定义“重要”与“吹毛求疵”的边界,以及哪些内容应跳过。 - 技术负责人确定人类阈值。评审发现本身不应批准或阻止 PR;分支保护仍要求代码所有者批准。若要按发现阻止合并,平台工程师可读取检查运行发布的严重性计数。
- 当评审者或作者在评审意见中标记
@claude时,Claude 会处理该意见并推送修复。PR 讨论串记录请求和改动;该修复回路通过claude-code-action运行。在托管服务中,@claude review请求的是新一轮评审。对于 Claude 创建的 PR,可以进一步让 Claude 持续照看它直到合并:团队可用自定义 slash command 扫描未解决的评审意见与失败检查,处理并推送修复,直到 PR 全绿、只等待代码所有者批准。 - 将评审发现反馈到
CLAUDE.md。某种错误第二次被评审指出时,就把纠正纳入该 PR 的CLAUDE.md;此后评审也会读取它并更早发现同类错误。评审同样应标出CLAUDE.md是否已过时。 - 技术负责人每月通过给发现打分、在
REVIEW.md中限制 nit 数量来调优。生成路径及 CI 已保证的内容应排除。
示例:REVIEW.md
# 评审说明

## Pass

运行三轮检查,并在每项发现上标注所属 pass:

- Bugs:逻辑错误、损坏的边界情况、隐蔽回归
- Security:注入风险、认证缺口、日志中的 PII
- Compliance:变更符合 spec.md、plan.md 与设计原则

## 本项目中“重要”的含义

仅将会破坏行为、泄露数据或违反政策的问题标为 Important。
风格与命名属于 nit。

## 限制 nit

每个评审最多报告五个 nit;其余只汇总数量。

## 不要报告

src/gen/ 下的生成文件,以及 CI 已强制的任何内容。
治理注意事项
职责分离仍被保留:写代码的 agent 无法批准代码。REVIEW.md 中的评审政策应用于所有 PR;发现、修复、评分与批准均记录在 PR 历史中,因此 PR 就是审计记录。批准来自人类通过分支保护作出,评审发现只是为其提供信息。
将 hooks 设为审批关口
构建阶段的 hook 是无需人工参与的护栏:允许或阻止动作。hook 也可以要求确认,让动作暂停,直到特定人员批准;发布门禁正是这一机制最清晰的用例。
该 play 被放在阶段 5“部署”,但 hook 并非部署专属;Claude 行动时都能触发。例如,阶段 3 中它们可以阻止在没有变更工单时编辑迁移和基础设施;阶段 4 中它们可以阻止修 bug 的 agent 编辑测试。
如何执行
- 工程领导、变更管理与合规共同列出必须保留的人类审批关口,如变更管理签核、发布授权和受保护路径编辑。
- 平台工程师将每道门表达成一个 hook:在 Claude 行动前运行的脚本,可允许、询问或阻止。
- 团队 hook 放在 Git 中的
.claude/settings.json;不可协商的 hook 放在由平台或 IT 管理员持有的托管设置中,使个人工程师无法关闭。 - 阻止动作时应说明原因,Claude 的输出应展示被阻止原因及获得批准的路径。
示例:.claude/settings.json
{
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Bash",
        "hooks": [
          {
            "type": "command",
            "command": "${CLAUDE_PROJECT_DIR}/.claude/hooks/production-gate.sh"
          }
        ]
      }
    ]
  }
}示例:.claude/hooks/production-gate.sh
#!/bin/bash
# 生产部署需要具名的发布授权
cmd=$(jq -r '.tool_input.command' < /dev/stdin)
if [[ "$cmd" == *"deploy"* && "$cmd" == *"production"* ]]; then
  if [ -z "$RELEASE_APPROVAL" ]; then
    echo "生产部署需要发布授权。" >&2
    exit 2 # exit 2 会阻止动作;信息会返回给 Claude
  fi
fi
exit 0
治理注意事项
Hooks 就是审批关口。门禁条件每次、对每个人都被强制执行;允许和阻止的决定均带时间戳记录。门禁同时定义“何为批准”,例如已批准的变更工单或发布经理的签字。
CI/CD 集成与部署
在 CI/CD 流水线中非交互式运行 Claude Code;对执行进行沙箱隔离,让长时间运行的 agent 安全工作;通过 MCP 集成暴露部署能力;并在 agent 真正需要之前演练回滚路径。
如何执行
- 从只读的判断工作开始:在流水线任务中用
claude -p分诊失败构建、总结 flaky test 或起草变更日志。 - 在已有关口之后增加写入步骤,用于修复 lint、更新生成文档或处理
@claude评审意见。agent 写出的任何内容都以 PR 进入分支保护,不能直推 main。 - 对执行进行沙箱隔离。agent 任务在具有网络策略与短期、受限 token 的容器中运行,默认不持有生产凭据。
- 通过 MCP 暴露部署能力。部署、状态与回滚成为按环境限定的工具,agent 的部署权限是一份允许列表,而不是含凭据的 shell 脚本。
- 按环境分层自治:开发环境中 agent 可自由部署;生产环境中 agent 准备发布、发布经理授权,且 hook 强制生产门禁;预发布环境介于两者之间。
- 回滚必须是管线中演练最充分的路径:一条 agent 可执行、且在预发布环境定期演练的命令。阶段 6 的闭环 play 会在控制带被突破时调用它,因此必须提前验证。
示例:流水线步骤
- name: 分诊失败构建
  if: failure()
  run: >
    claude -p "阅读 out/build.log 中的构建日志。识别最可能的原因,说明
    失败更像 flaky 还是确定性问题,并为 PR 讨论串写一段三行总结。" >> triage.md
治理注意事项
核心原则是:agent 可以行动直到生产门禁,但不能穿越它。以下控制共同确保这一点:
- 分支保护让 agent 的每次写入都成为 PR,无法直接进入 main。
- 生产部署 hook 在具名发布经理授权前阻止发布。每次非交互运行都以 agent 自身身份执行,因此流水线日志能区分 agent 做了什么与触发它的工程师做了什么。
- 按环境划分的权限层级,规定 agent 在抵达门禁前可行动到什么程度。
阶段 6:维护
维护与闭环
至此,我们讨论的是如何把 Claude 加入 SDLC 各阶段,每个阶段的最初步骤都需要人启动。维护阶段则转向自主运行 Claude,以闭合这个回路。
例如,一个持续运行的监控 agent 可以在 bug 工单出现后创建 intent.md,并依次流经需求、计划、构建、测试与评审。阶段 6 以无头方式运行;阶段之间设置独立的置信度关口,由确定性检查或对抗性审查 agent 判断上一阶段的产出是继续流动还是升级给人。
闭合回路
确定性脚本监控生产环境,并在控制带被突破时调用 Claude。告警越界是自主循环的一个有益例子;本阶段末尾的 Claude Tag(公开测试版)部分,则涵盖从不同渠道进入的工作。
如何执行
- 服务负责人或平台工程师选择一个具有稳定滚动基线的指标,例如 CI 测试失败率、部署后 5xx 比率或 PR 周期时间。
- 编写检测脚本,通常是在滚动窗口上计算均值与标准差,并使用 Western Electric 或类似规则,使控制带既能捕捉尖峰,也能捕捉缓慢漂移。脚本应受版本控制并有单元测试;检测完全保持确定性,不涉及模型。
- 在版本控制配置(如下方
bands.yaml)中定义响应层级:1σ 仅记录;2σ 调用只读 Claude 诊断;3σ 时 Claude 可以行动,但仅能创建进入评审门禁的 PR 或触发已批准的 runbook。 - 触发层可以是 GitHub/GitLab 的定时工作流、现有监控栈的 webhook,或网络内的 Cron Job。Claude 以无状态、非交互方式在 CI runner 或沙箱容器中的 Agent SDK 服务运行,因此一次循环无需任何人启动就能开始和结束。
- agent 按阶段 1“规划”的格式,将诊断写为
intent.md:包括异常、证据、预期结果、受影响系统和未决问题;然后像其他工作一样通过管线。 - 服务负责人或值班工程师分诊队列,并将面向产品的发现交给产品负责人:立刻修、排期或关闭。关闭项用于调节控制带、减少噪声。
- 修复发布后,为该事故新增一项 eval(持续评测 play),让系统今后能防止同类问题。
示例:监控 CI 测试失败率的 bands.yaml
metric: ci_test_failure_rate
baseline: rolling_30d
rules: western_electric
tiers:
  1sigma: {action: log}
  2sigma:
    action: diagnose
    tools: 'Read,Grep,Bash(gh run view *)'
  3sigma:
    action: propose
    routes: [pull_request, runbook:rollback-deploy]
治理注意事项
分级边界由版本控制的配置强制实施;权限和托管设置拒绝生产访问。调用、发现与分诊决定均有时间戳记录。服务负责人对发现进行分诊和批准;由此产生的改动走正常 PR 评审门禁;agent 可触发的 runbook 都已提前批准。
示例情形
- CI 测试失败率超过 3σ 时,agent 隔离 flaky test 或创建回退 PR,由评审门禁决定。
- 部署后 5xx 比率超过 3σ 且窗口内存在一次部署时,agent 触发现有的回滚流水线。
- PR 周期时间触发漂移规则时,agent 为工程领导层写报告,说明这套机制既可用于流程指标,也可用于生产指标。
通过 Claude Tag 值班
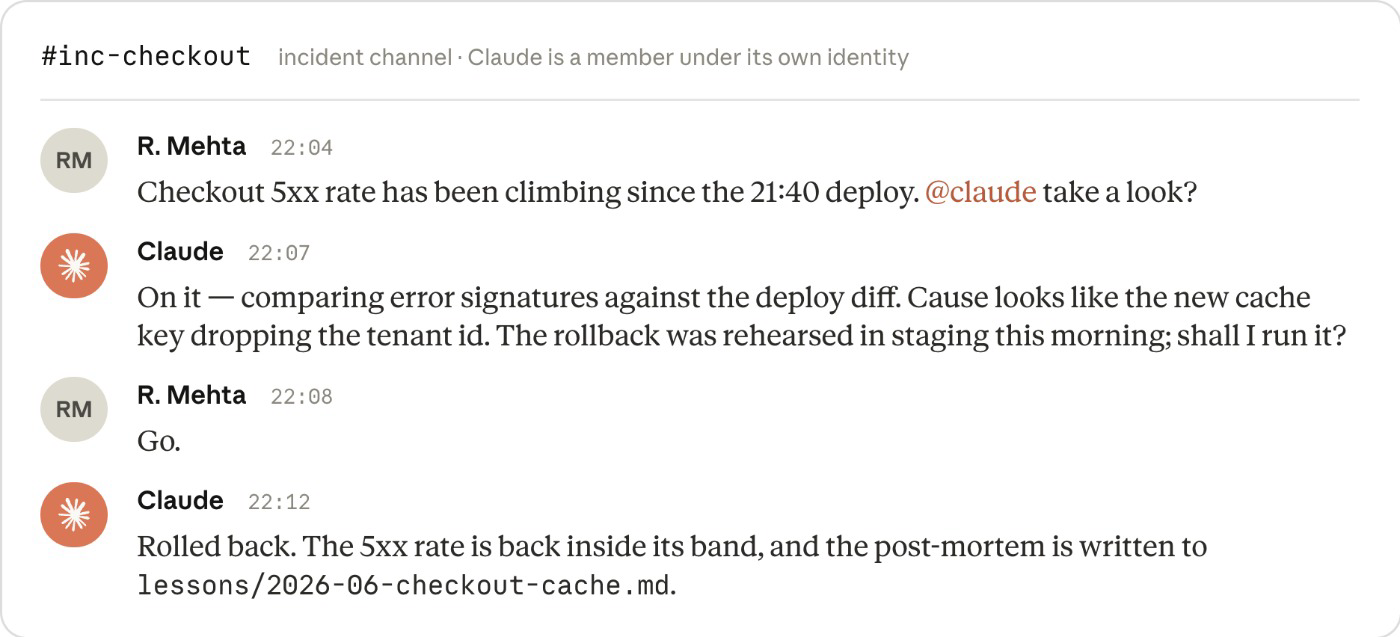
事故也可能来自 Slack、Teams 等工作通信应用:例如晚上 10 点在事故频道发出一条紧急修复消息。Claude Tag(目前公开测试版,支持 Slack)让 Claude 以自己的身份加入这些频道,因此每个新事故都拥有一个第一响应者;响应本身也成为未来循环的记忆。
对话和机构知识留在频道中,频道内任何人都可引导并推动响应。团队成员可以实时检验假设、探索新选项和调查;频道历史也增强了可审计性。Claude 可经 MCP 验证指标已回到基线并在讨论串确认,再把复盘写入受版本控制的经验文件,供后续调查读取。
Claude Tag 接手的不只是事故。通过 MCP 在工单中标记它,或在频道中提问,都可触发同样的分诊:小而边界明确的修复以 PR 穿过评审门禁;更大的工作则写成阶段 1 的 intent.md,循环从此自我供给。
结语
模型与 harness 已变得更加成熟。组织能够改造的不只是产出代码的方式,而是整个软件开发生命周期。
这一转型始终把人类判断放在流程中心,也考虑了大型企业的治理与监管要求。
本指南汇总了应用 AI 团队为客户日常执行的大量真实最佳实践。希望它能成为一份实际可用、可付诸行动的参考。
资源与致谢
下列文档是平台团队建立上述控制措施所需的材料,顺序大致对应落地顺序。
- 为组织设置 Claude Code:管理员决策地图,从这里开始
- 设置参考与优先级:包括全部仅限托管设置的配置项
- 通过 Claude 管理控制台管理的服务器端设置
- 权限
- 沙箱:操作系统级的文件系统与网络隔离
- Hooks 指南
- Hooks 参考
- Skills
- Plugins 与私有市场:如何在组织范围分发 skills 和 hooks
- 受管 MCP:集中控制 agent 的工具表面
- 企业部署概览:Bedrock、Vertex 与 Foundry
- 企业网络配置
- 监控(OpenTelemetry)
- 分析仪表盘
- Compliance API:Enterprise 活动流、对话检索与删除
- 安全模型
感谢 Jim Blackhurst、Will Steuk 和 Jamal Arif 对本指南的贡献;本指南受到他们先前大量工作的启发,也建立在这些工作之上。